
生成AIを社内業務や顧客対応に組み込む企業が増え、LLMの回答に個人情報や機密情報が混じるリスクが運用課題になっています。
入力側のガードレールだけでは、外部データ・過去ログ・社内ナレッジ経由の意図しない露出は防ぎきれません。
一方で、マスキングを厳しくしすぎると業務価値が下がります。この記事では、LLM出力への個人情報・機密情報マスキング設計を、検出方式・運用フロー・限界の観点で整理します。
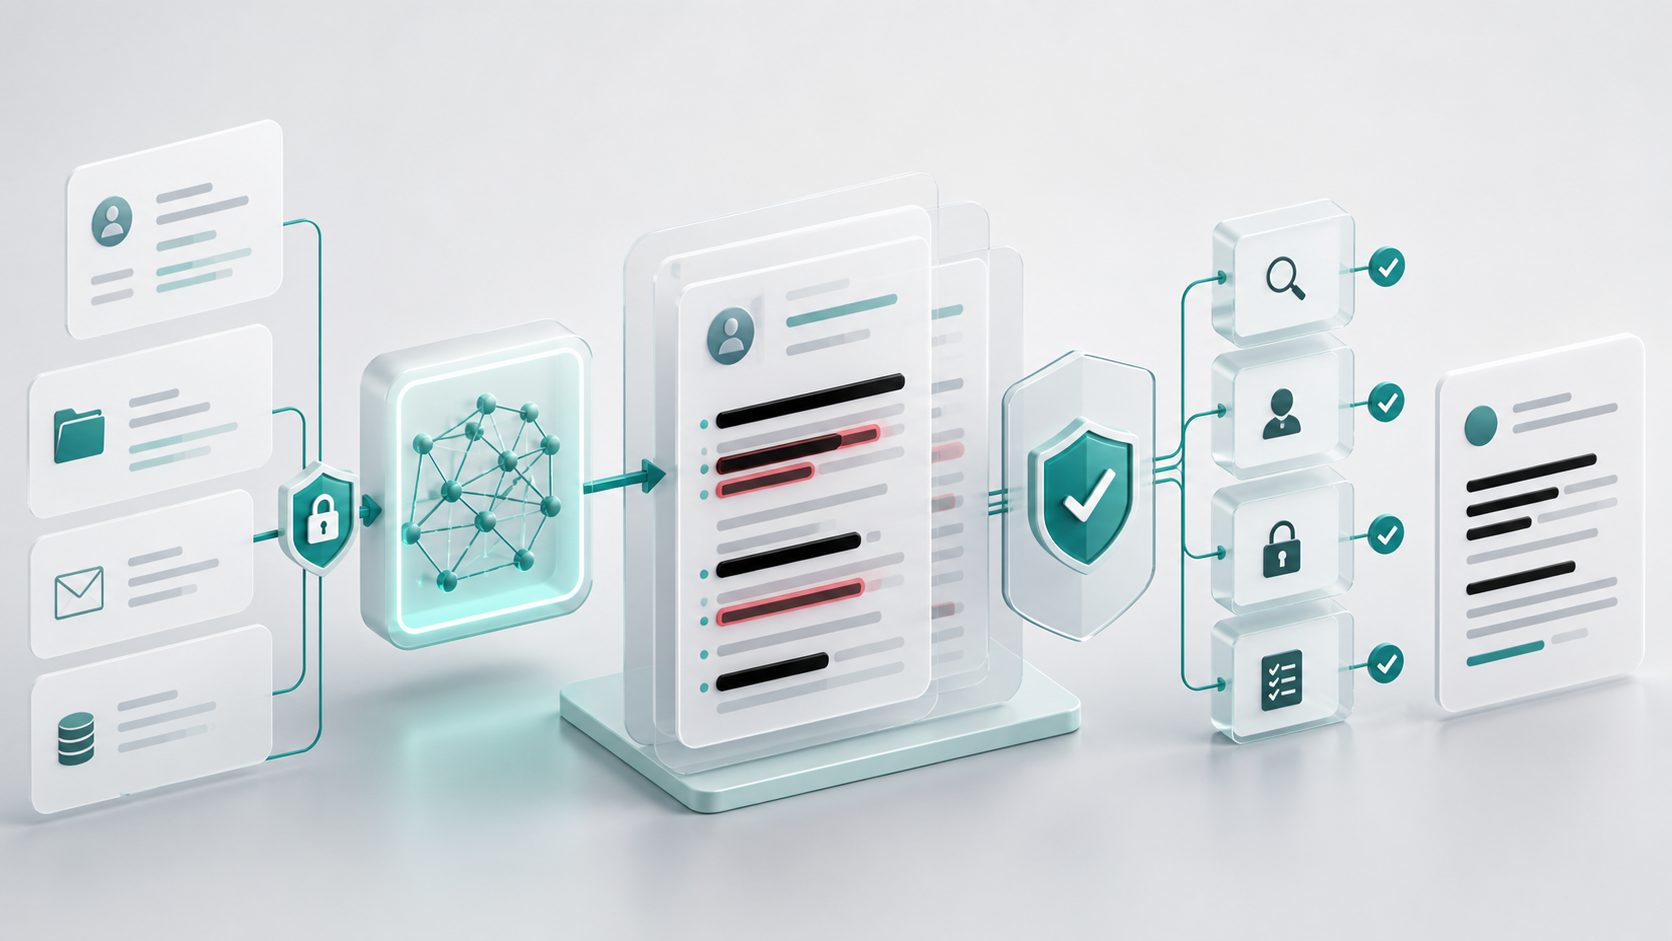
生成AIを社内業務や顧客対応に組み込む企業が増え、LLMの回答に個人情報や機密情報が混じるリスクが運用課題になっています。
入力側のガードレールだけでは、外部データ・過去ログ・社内ナレッジ経由の意図しない露出は防ぎきれません。
一方で、マスキングを厳しくしすぎると業務価値が下がります。この記事では、LLM出力への個人情報・機密情報マスキング設計を、検出方式・運用フロー・限界の観点で整理します。
| 読者の課題 | 最初に見る指標 | 確認すること | 次の行動 |
|---|---|---|---|
| 出力に個人情報が混じるリスクを把握したい | 検出対象カテゴリ、誤検出率 | 何をPIIとするかの定義があるか | データ分類ポリシーを先に決める |
| どのマスキング方式を採るか迷う | 検出精度、遅延、コスト | ルール、辞書、モデルのどれを主軸にするか | 段階的な多層検出を検討する |
| 業務価値を落とさず運用したい | 過剰マスク率、業務再問い合わせ率 | 例外運用と復元手順があるか | 例外承認と監査ログを整える |
※LLM関連サービスの機能、料金、データ保持条件は変更される場合があります。導入前に公式情報で最新条件を確認してください。
LLM出力マスキングは、生成AIが返した文章から、個人情報・社内機密・契約情報・認証情報などを検出し、伏字化・置換・遮断する仕組みです。入力側の禁止語フィルタとは役割が異なります。
主に扱う情報例は次のとおりです。
用語補足の一覧です。
| 用語 | 意味 |
|---|---|
| PII | 個人を特定できる情報。氏名、住所、連絡先などを含む |
| DLP | データ漏洩防止の総称。検出・遮断・監査を含む |
| マスキング | 出力の一部を伏字や置換で保護する処理 |
| ゴールデンデータセット | 正解例を集めた評価用データ |
| 監査ログ | 検出結果と対応履歴を後から追える記録 |
LLMの回答は、入力プロンプトだけでなく外部データ・過去会話・RAG検索結果・ツール応答からも構成されます。
出力段階でしか捕捉できない露出経路が増えているため、入力ガードだけでは不足します。
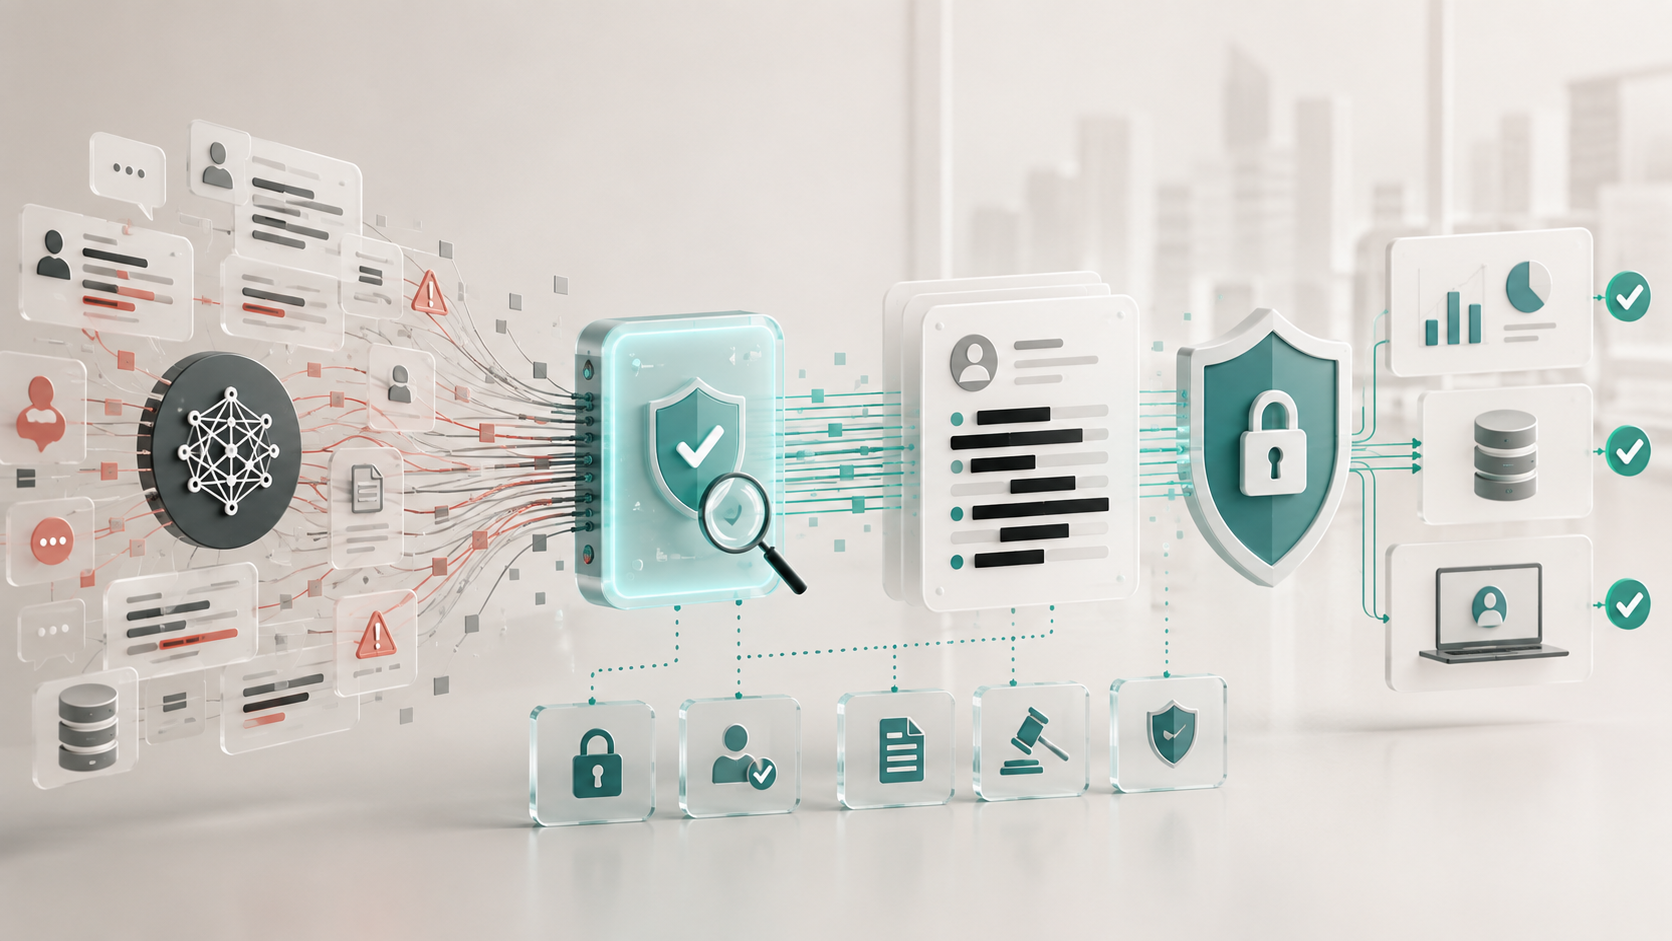
主なリスクは次の3つです。
規制や取引先要件も強まっており、監査ログと合わせた運用が求められます。
出力マスキングは単一方式で完結しません。定型情報、自然文情報、高リスク領域で使う手法を分け、企業運用の観点で整理します。
| 方式 | 一言でいうと | 向くケース | 注意点 |
|---|---|---|---|
| 正規表現・辞書ベース | パターンや語彙で検出する | 番号系・鍵情報など定型データ | 文脈依存の情報を取り逃がしやすい |
| 固有表現抽出(NER)モデル | 学習済みモデルで名前や組織を検出する | 氏名・組織名・住所など自然文中の情報 | 誤検出と多言語対応の限界がある |
| LLMベース分類・書き換え | 別のLLMで判定・伏字化する | 文脈判定や社内独自カテゴリ | 遅延とコストが増える |
| ポリシーベースの遮断 | 検出時に応答自体を止める | 高リスク領域や規制対応 | 業務が止まりやすく例外運用が必要 |
判断軸ごとの見方は次のとおりです。
| 比較軸 | 確認すること | 実務上の意味 |
|---|---|---|
| 検出精度 | 対象カテゴリ、誤検出率、見逃し率 | 業務停止と情報漏洩のバランスを決める |
| 遅延 | 応答時間への上乗せ | チャット体験と業務効率に影響する |
| コスト | 追加API呼び出しやモデル利用料 | 月次コストと投資対効果を決める |
| 監査性 | 検出理由と対応履歴の残り方 | インシデント対応と規制対応で使う |
| 例外運用 | 承認、再送、復元の手順 | 過剰マスクによる業務停滞を防ぐ |
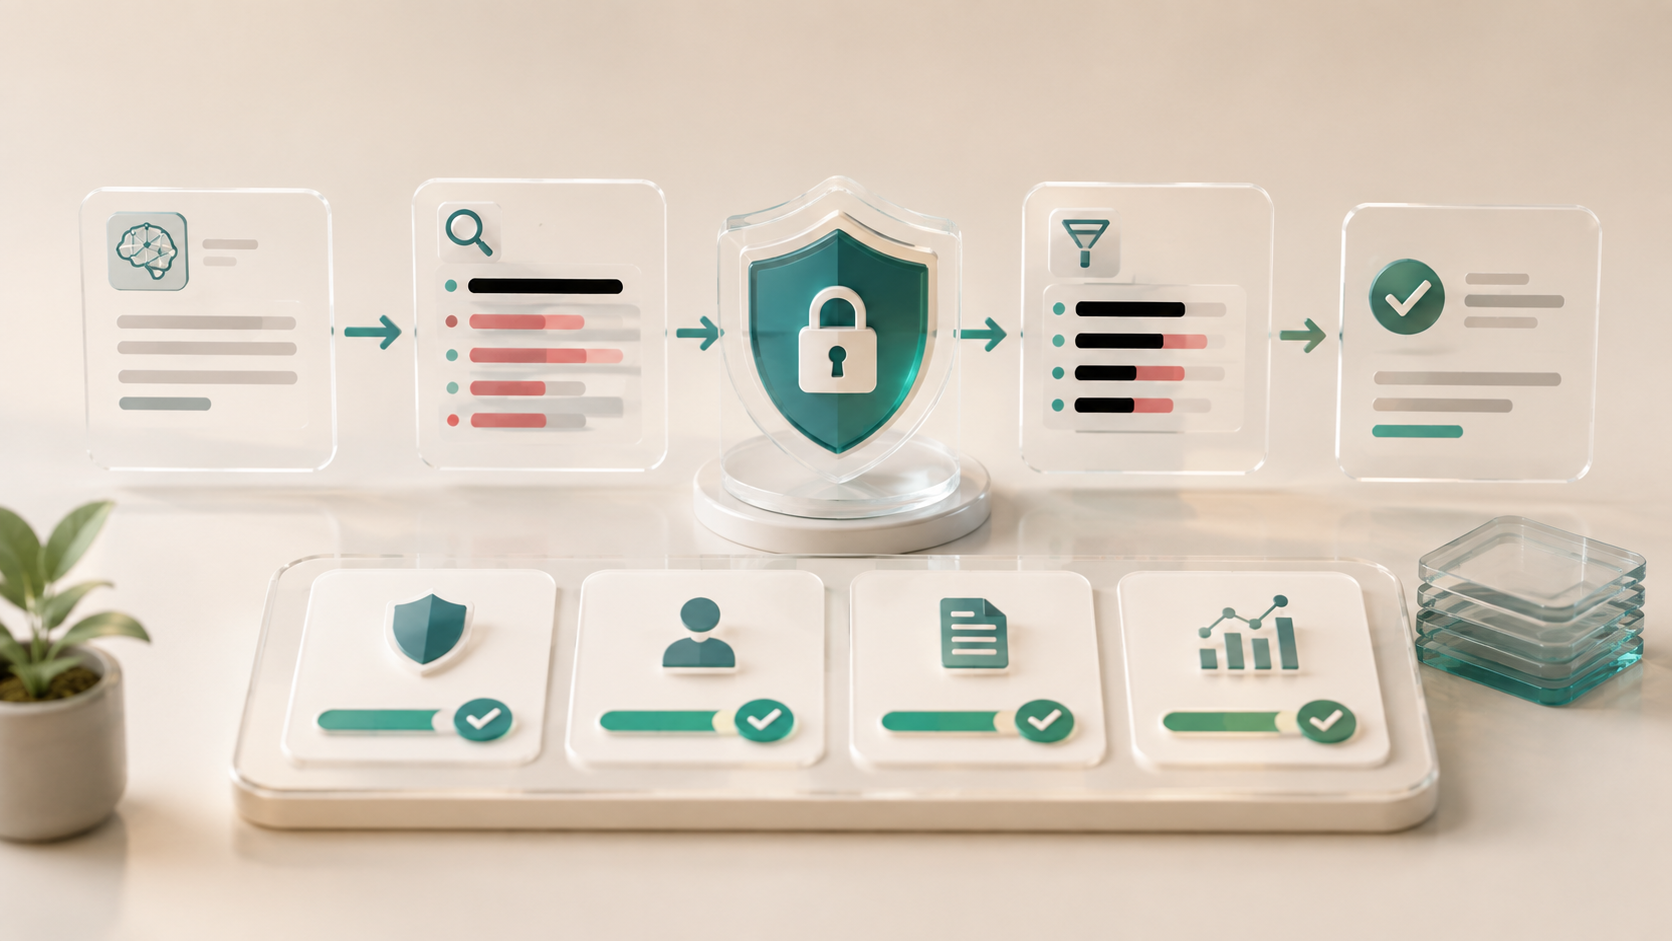
多くの企業では、定型情報を正規表現で、自然文情報をNERやLLM判定で、高リスク領域を遮断ポリシーで押さえる多層構成が現実解になります。
出力マスキングは先に運用ルールと監査体制を決めてから技術選定に入るのが失敗を減らす順序です。導入前と運用開始後に見る項目を分けて整理します。
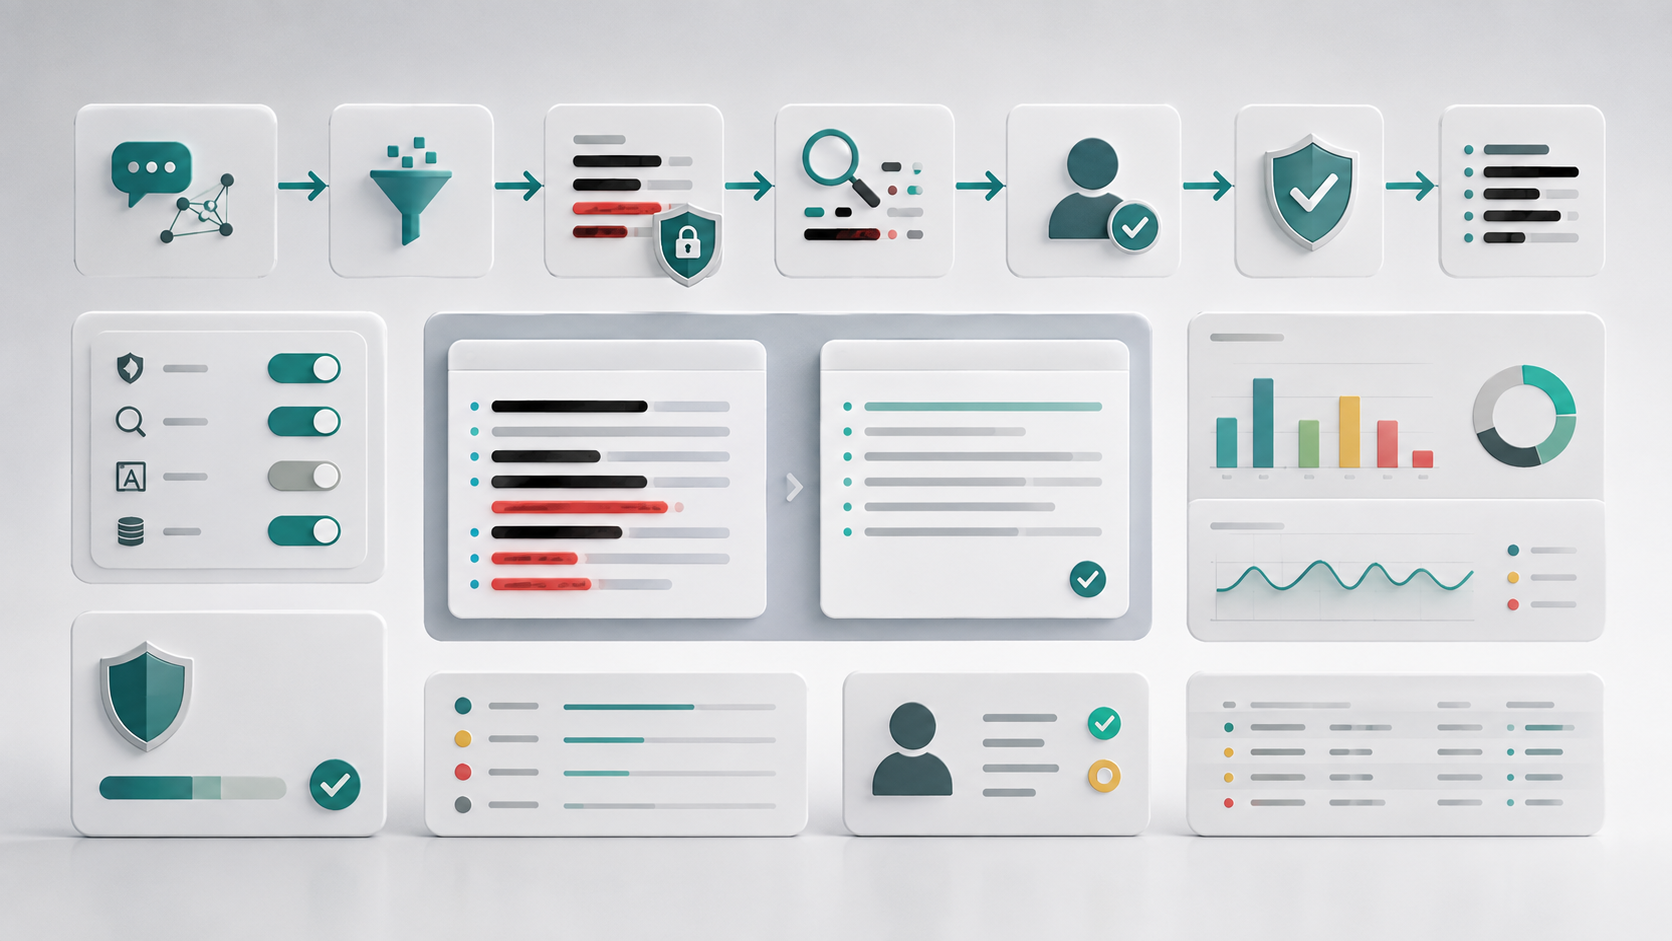
導入後に継続して見る指標も分けます。
| 指標 | 何を見るか |
|---|---|
| 検出件数と種別内訳 | どのカテゴリが多いかで運用改善の焦点を決める |
| 誤検出率 | 業務停滞や再問い合わせにつながる |
| 見逃し率 | サンプル監査や苦情から推定する |
| 例外承認件数 | 想定外運用が増えていないかを確認する |
| 遅延上乗せ | 体験劣化とインフラ費用に影響する |
出力マスキングは万能ではありません。前提を整理します。
採用しないほうがよいケース:
注意
マスキング機能を持つツールやモデルは、公式情報でデータ保持条件・学習利用・監査ログ仕様を確認してください。二次記事だけで断定しないでください。
Blackfordは、出力マスキングを「単独のフィルタ機能」ではなく、データ分類・RAG設計・業務フロー・監査運用と一体の運用ループとして設計することを勧めています。
社内データ活用やDataRoidによるRAG導入では、検索対象データの分類とマスキング方針を同時に決めると後戻りが減ります。
VPCや権限設計を伴う場合はDataRoid Cloudでクラウド構成と合わせて検討します。
監査ログ設計はLLMアプリの監査ログ・引用トレース設計、入力側の防御はプロンプトインジェクション対策と組み合わせるのが実務的です。
代替できません。入力を制限しても、RAG検索結果、社内ナレッジ、ツール応答など出力を構成する情報源から機密情報が流れる可能性があります。入力側と出力側は設計を分けて考えます。
まず対象カテゴリを絞り、定型情報の正規表現検出と監査ログから始めるのが現実的です。誤検出と業務影響を見ながら、NERやLLM判定を段階的に足していく設計にすると運用が破綻しにくくなります。
利用するモデルやサービスによって条件が異なります。企業利用では、学習不使用の契約プラン、VPC接続、ログ保持期間、監査対応の可否を公式情報で必ず確認してください。二次記事の記述だけで判断しないでください。
例外承認フローと復元手順を先に決めておくことが最善策です。承認者、有効期限、再送方法、監査記録の残し方を明文化し、想定外運用が増えていないかを継続的にレビューします。
既製のNERモデルは、言語ごとに精度差が大きく、社内固有表現は取りこぼしやすい傾向があります。対象言語ごとの評価データを別途整備し、業務で扱う固有語彙を辞書に加える運用が必要です。
LLM出力マスキングは、生成AIを業務で安全に使うための出力側の最終防衛線です。
ただし単独のフィルタ機能では設計しきれず、データ分類・RAG設計・業務フロー・監査運用と一体で考える必要があります。
対象カテゴリの定義、多層検出、例外運用、監査ログを先に決めれば、過剰マスクによる業務停滞と情報漏洩リスクのバランスを取りやすくなります。
自社での適用に迷う場合は、扱うデータと業務課題を整理したうえで専門家に相談してください。
\LLM出力の情報漏洩対策を業務全体で設計します/
Blackfordに相談する




