LLMを本番運用するときは、精度・幻覚率・遅延・コストの4指標を継続で見える化する必要がある。指標を並べるだけでは品質低下を判断できず、変更のたびに合否が揺れる。
この記事では、オフライン評価・オンライン評価・人手レビューの3層設計を整理する。ゴールデンデータセットとLLM-as-a-judgeの使い分けも扱う。運用開始時に決める合格基準と、月次で追うべき指標を判断できる。

LLMを本番運用するときは、精度・幻覚率・遅延・コストの4指標を継続で見える化する必要がある。指標を並べるだけでは品質低下を判断できず、変更のたびに合否が揺れる。
この記事では、オフライン評価・オンライン評価・人手レビューの3層設計を整理する。ゴールデンデータセットとLLM-as-a-judgeの使い分けも扱う。運用開始時に決める合格基準と、月次で追うべき指標を判断できる。
読者の課題ごとに、最初に見る指標と次の行動を整理した。運用整備の順序を決める起点として使う。
| 読者の課題 | 最初に見る指標 | 確認すること | 次の行動 |
|---|---|---|---|
| 回答品質が安定しない | 正答率、幻覚率、修正率 | 失敗ログと合格例の有無 | ゴールデンデータセット作成 |
| API費用が読めない | 1リクエスト単価、トークン数 | モデル選択とプロンプト長 | ルーティングとキャッシュ導入 |
| 体感が悪化した | P95応答時間、失敗率 | 変更履歴と監視アラート | 変更前後の指標比較 |
| ガバナンス上不安 | 監査ログ、入力データ種別 | 保存範囲と権限管理 | ログ保管方針と統制整備 |
LLM評価は「新しいプロンプトやモデルが業務要件を満たすか」を判断する行為である。モニタリングは「本番で品質・コスト・遅延が想定内に収まっているか」を継続確認する行為である。
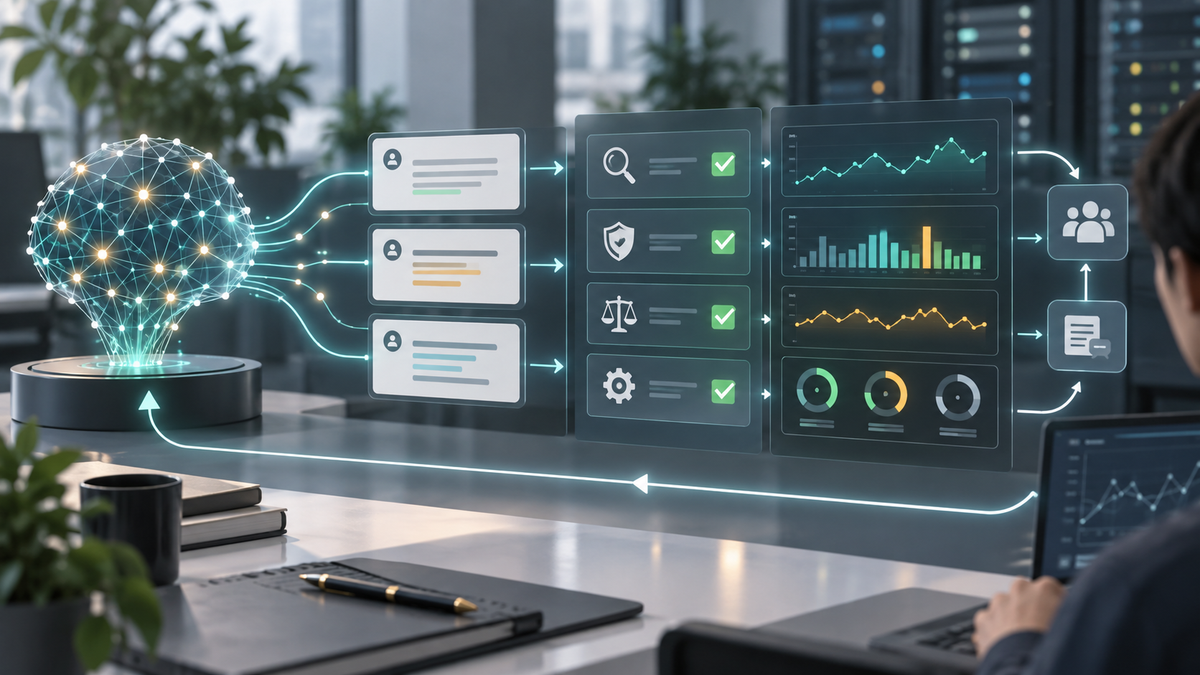
両者は目的が異なる。評価は変更判断、モニタリングは日次・週次の傾向監視で使い分ける。
用語は次のとおり整理する。本文前半では専門語を連続させない。
| 用語 | 意味 |
|---|---|
| LLMOps | LLMを業務で継続利用するための運用管理 |
| ゴールデンデータセット | 正解や合格例をまとめた評価用データ |
| LLM-as-a-judge | 別のLLMで回答の合否を判定する自動評価 |
| 幻覚率 | 事実と異なる回答を返す割合 |
| 修正率 | 後工程やユーザーが回答を修正した割合 |
LLMアプリの本番導入が広がるほど、品質と費用の変動を同時に管理する必要が高まる。評価と監視が整っていないと、モデル差し替えやプロンプト改訂で合否判断ができなくなる。
特に問題になりやすいのは次の3点である。
これらは、いずれも合格基準と指標の記録がないことに起因する。
評価と監視は、オフライン評価・オンライン評価・人手レビューの3層で組む。1つに寄せると判断が偏る。
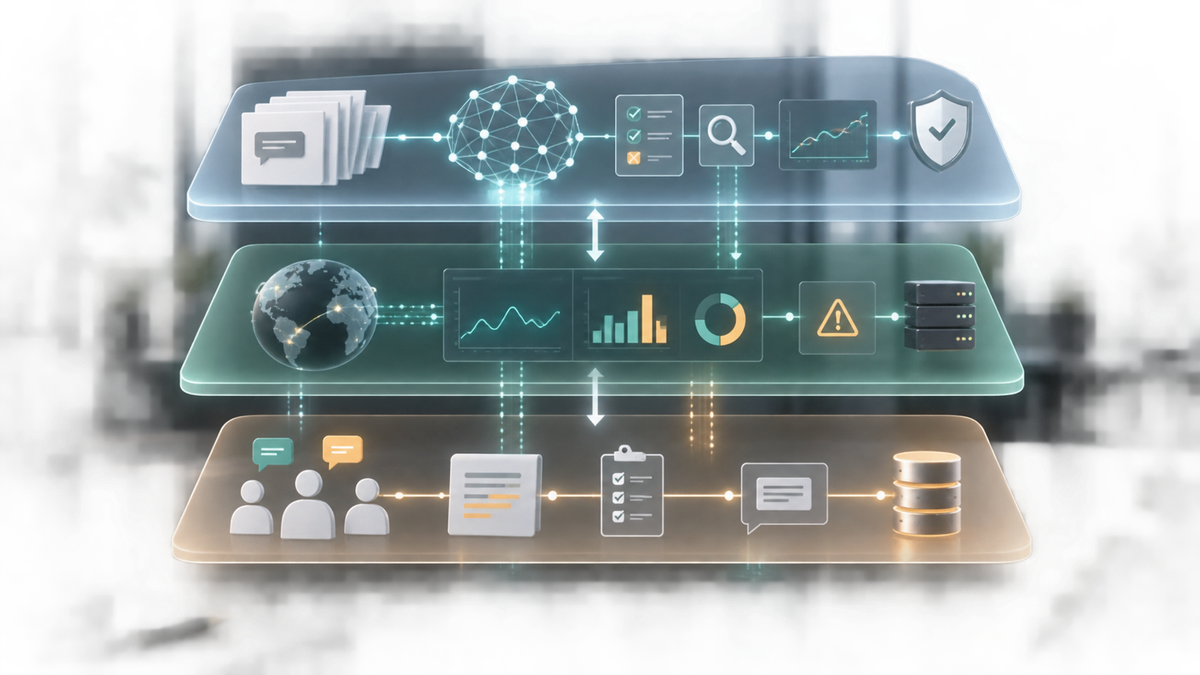
3層は次のように補い合う。
| 方式 | 一言でいうと | 向くケース | 注意点 |
|---|---|---|---|
| オフライン評価 | 事前用意した正解データで採点 | プロンプト改訂・モデル切替の判断 | データが古いと本番と乖離する |
| オンライン評価 | 本番トラフィックの指標監視 | 継続監視・SLO維持 | 正解データがなく間接指標中心 |
| 人手レビュー | 担当者が回答を実際に確認 | 高リスク業務・自動評価の校正 | コストが高く頻度設計が必要 |
ゴールデンデータセットは、業務で正解が明確な入出力ペアを集めて作る。最初は30〜100件でよい。
守ること:
件数を増やすより、期待出力の粒度をそろえるほうが評価の再現性は上がる。
LLM-as-a-judgeは、大量回答を一次評価するときに使う。全件を人手で見る余力がない場合の効率化手段である。
避けるべき条件:
判定用プロンプトは、必ず人手評価と突合し、判定LLM自身の精度を測る。
本番で見る指標は、品質・コスト・遅延・安全の4カテゴリに分ける。すべてを毎日見る必要はない。
| 比較軸 | 確認すること | 実務上の意味 |
|---|---|---|
| 品質 | 正答率、幻覚率、修正率 | 業務要件に合っているか |
| コスト | 1リクエスト単価、キャッシュ率 | 月次費用の変動要因 |
| 遅延 | P50・P95応答時間、失敗率 | 体感速度とタイムアウト設計 |
| 安全 | プロンプト逸脱、監査ログ | ガバナンスと事故対応 |
評価と監視の整備前に、次を決めておく。
運用開始後は、頻度を分けて定点観測する。
以下の状況では、評価基盤や監視ツールの導入を先に急がないほうがよい。
これらは、まず運用体制と業務要件の整理を先に進めるほうが、後戻りが少ない。
LLM評価は本番品質を保証する仕組みではない。過信を避けるため、次のリスクを踏まえる。
※LLM関連サービスの料金、データ保持条件、提供機能は変更される場合があります。導入前に公式情報で最新条件を確認してください。
Blackford Technologiesは、LLM・AIエージェント開発支援の一環として、LLM評価・モニタリングの整備を「ツール選定」ではなく業務要件と運用責任の設計から始める方針で支援する。
具体的には次の視点で整理する。
社内データやRAG基盤の運用と一体で評価データを整えたい場合は、DataRoidやDataRoid Cloudと組み合わせて設計できる。営業・顧客対応でのLLM運用は、SalesRoidと評価データを連動させると、修正率の傾向を業務改善につなげやすい。
関連コラムとして、コスト設計とプロンプト運用はLLMのプロンプト管理とコスト最適化を参照できる。事故対応の観点ではLLMインシデント対応プレイブックも参考になる。
評価は変更前後で品質を比較する行為、モニタリングは本番運用中の品質・コスト・遅延を継続確認する行為です。評価は不定期、モニタリングは日次〜週次で回します。両者を組み合わせて使います。
正答率、幻覚率、修正率、遅延、1リクエスト単価の5つに絞ります。業務によっては、指示遵守率やツール呼び出し成功率を追加します。指標を増やしすぎると、判断が遅くなります。
最初は30〜100件で始めます。業務ドメインが広い場合は、機能単位で30件ずつ整えます。本番ログから失敗例と重要事例を追加し、四半期ごとに見直します。件数を増やすより粒度をそろえるほうが重要です。
リクエスト数が少なくても、幻覚率と修正率の記録は必要です。スプレッドシートで週次に手集計する形でも始められます。事故対応と改善のため、最低限のログと合格基準は運用開始時から用意します。
判定LLM自身の精度を人手レビューで検証していない場合、そのままでは信頼できません。まず判定LLMの合格率を人手結果と突合し、乖離傾向を把握します。高リスク業務では必ず人手レビューを併用します。
LLMを本番で使うときは、評価とモニタリングを分けて設計する。オフライン評価・オンライン評価・人手レビューの3層をつなぐと、変更判断と継続監視の両方が回りやすい。
ただし、ツール選定より先に、合格基準・ゴールデンデータ・ログ運用の合意が必要である。運用体制を伴わない評価基盤は形骸化しやすい。
社内でLLM評価・モニタリング設計を組み込みたい場合は、業務要件と既存データを整理したうえで、専門家への相談を推奨する。
\LLM評価・監視の運用設計を相談できます/
Blackfordに相談する