
本番LLMアプリの障害は、通常のWebサービスと切り分け方が違います。モデル・プロンプト・参照データ・外部APIのどれが原因かを、限られた時間で判定できる手順が必要です。
この記事では、LLMアプリ本番運用のインシデント対応プレイブックを、障害分類・切り分けフロー・撤退判断・事後レビューの4段で整理します。事故を減らすだけでなく、事故後の学習を運用ループに戻す設計まで扱います。
本番LLMアプリの障害は、通常のWebサービスと切り分け方が違います。モデル・プロンプト・参照データ・外部APIのどれが原因かを、限られた時間で判定できる手順が必要です。
この記事では、LLMアプリ本番運用のインシデント対応プレイブックを、障害分類・切り分けフロー・撤退判断・事後レビューの4段で整理します。事故を減らすだけでなく、事故後の学習を運用ループに戻す設計まで扱います。
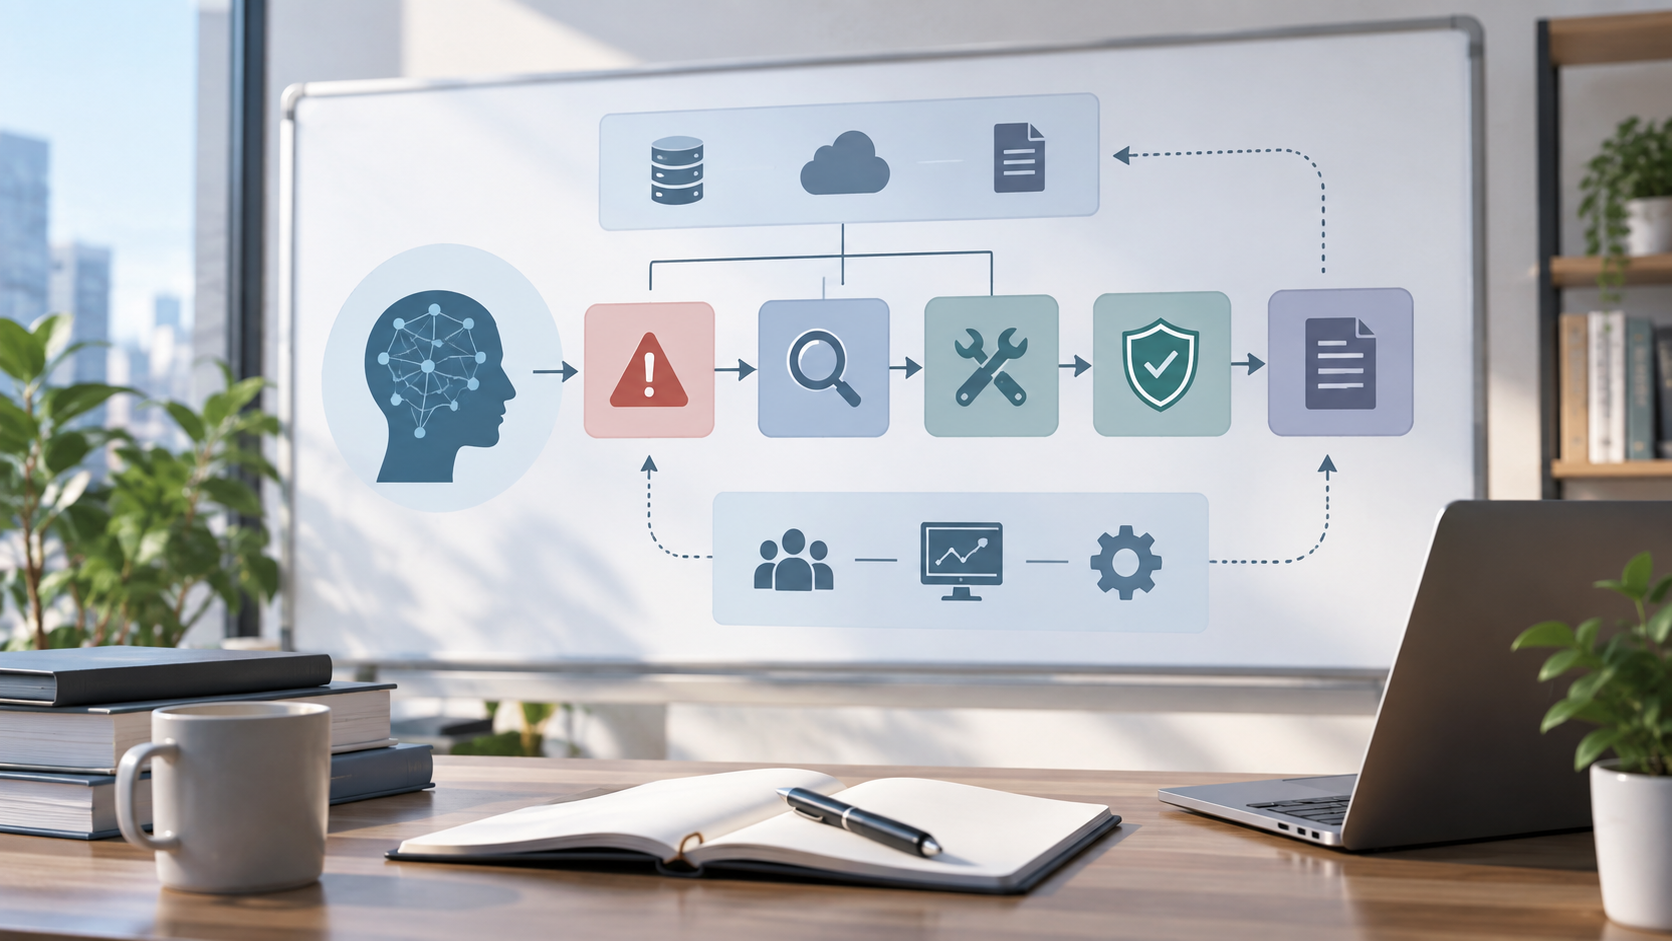
初動をチーム全員で揃えるため、次の判断表を用意します。
| 症状 | 最初に見る指標 | 疑うレイヤー | 初動アクション |
|---|---|---|---|
| 出力が急に的外れになる | 幻覚率、否認率、修正率 | プロンプト、モデル、参照データ | 直近24時間の変更を切り戻す |
| 出力形式が崩れる | JSON検証エラー率、パース失敗率 | モデル、指示文 | フォーマット検証と再生成に切り替える |
| レスポンスが極端に遅い | P95遅延、ツール呼び出し時間 | LLM API、外部ツール、経路 | 縮退モードで軽量モデルに切り替える |
| 費用が急伸する | トークン消費、キャッシュ率、リトライ回数 | プロンプト、ループ制御、キャッシュ | クォータと再試行上限を締める |
| セキュリティ懸念 | 監査ログ、機密検出ヒット率 | 入力データ、ツール権限 | 該当機能を一時停止する |
指標が揃っていない場合は、まず直近24時間の変更履歴を凍結してから調査を始めます。
LLM本番アプリの障害は、コード層だけでは説明しきれません。原因を切り分けるため、次の3層で考えます。
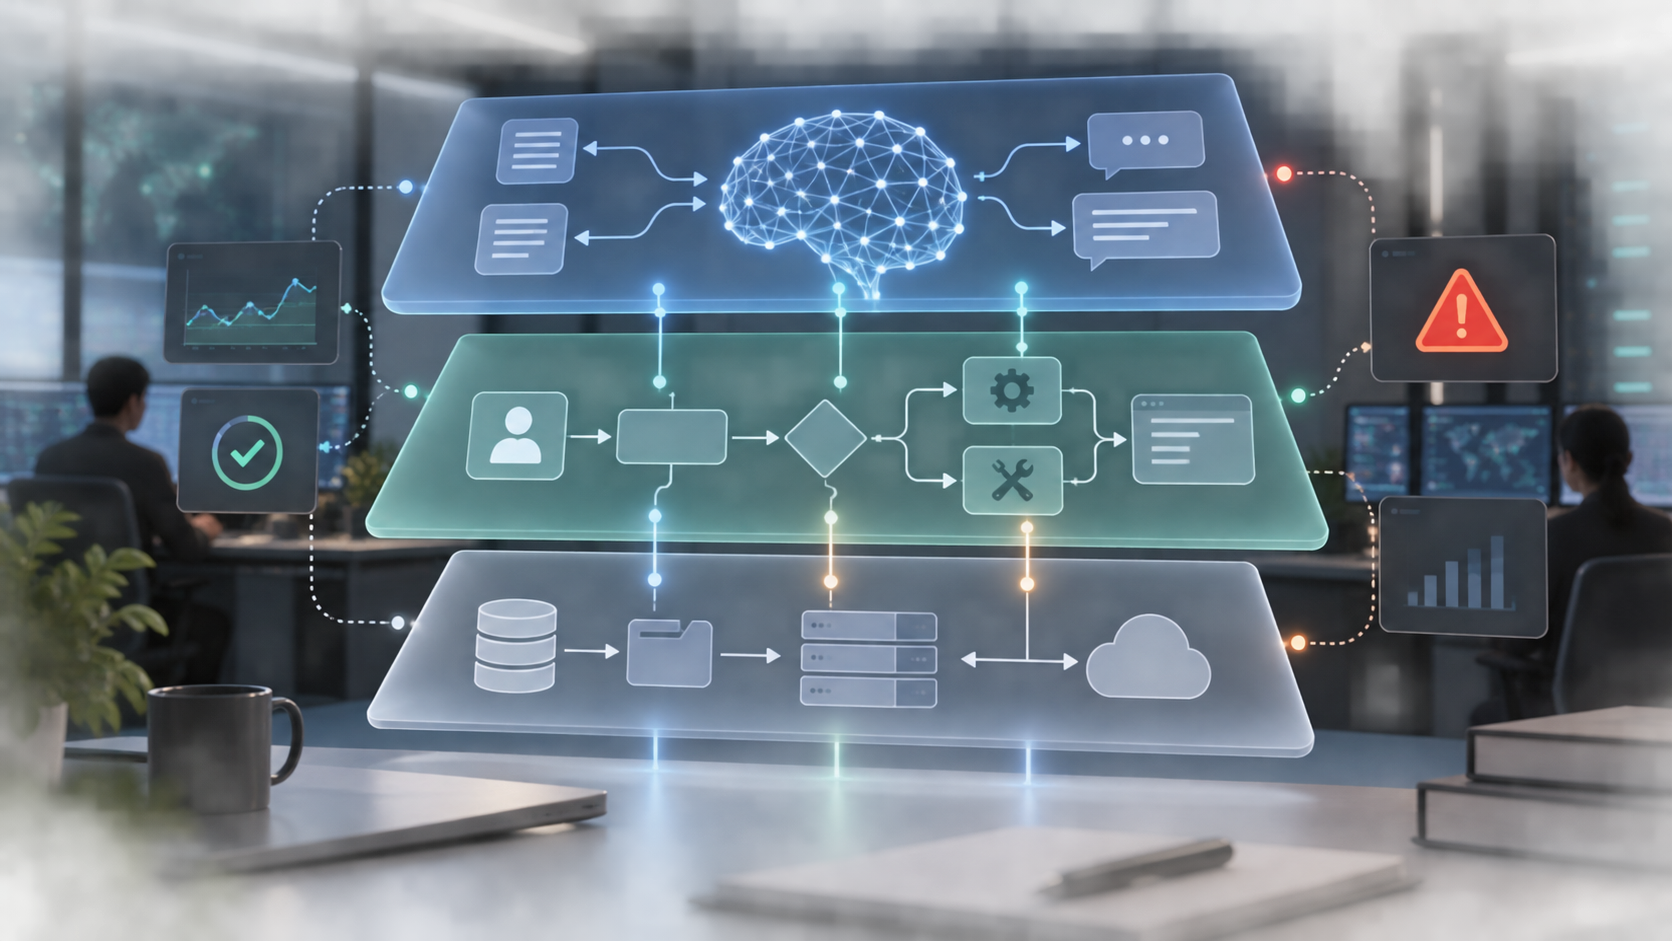
用語も先に揃えます。運用者や業務側が同じ会話に入るときの共通語として置きます。
| 用語 | 意味 |
|---|---|
| 幻覚率 | 事実と異なる回答の割合 |
| 出力ドリフト | プロンプトを変えていないのに応答傾向が徐々に変化する現象 |
| 縮退モード | 一部機能を停止し、限定的な応答だけを返す運用状態 |
| ゴールデンデータセット | 正解が確定した評価用データ |
| ポストモーテム | 事故後の原因分析と再発防止レビュー |
※LLM関連サービスの料金、API仕様、モデル提供状況は変更される場合があります。運用条件は導入前と障害発生時に公式情報で最新を確認してください。
LLMアプリでは、コードが変わらなくても品質が変動します。次の前提を運用ルールに持ち込む必要があります。
そのため、LLMインシデントでは症状の観測から仮説形成までを短くするプレイブックが要になります。
導入企業の裾野が広がり、単発PoCから常時稼働の業務組み込みへ移る事例が増えています。停止・誤答・情報漏洩の影響が業務プロセスに波及するため、事後対応だけでは追いつきません。
主な背景を4点で整理します。
まず全体像を1表で把握します。障害を「症状」ではなく「原因レイヤー」で分けるのが要点です。
| 障害パターン | 一言でいうと | 起きやすいタイミング | 注意点 |
|---|---|---|---|
| モデル挙動シフト | ベンダー更新で応答傾向が変わる | プロバイダの週次・月次更新後 | 変更告知を追っても差分は残る |
| 出力形式ドリフト | JSON等の期待形式が崩れる | プロンプト縮小、モデル切替時 | パーサ側の許容度で隠れる場合がある |
| RAG回答品質低下 | 参照文書更新で誤情報が増える | 社内ドキュメントの一括更新後 | インデックス再作成の欠落が原因になる |
| ツール呼び出し暴走 | エージェントが無限ループする | 新ツール追加や権限拡張の直後 | ツールコール回数の跳ねを監視で検知 |
| コスト事故 | トークン消費が急伸 | ループ、長文プロンプト、リトライ増 | 実費が判明する前に検知する仕組みが要る |
| セキュリティ事故 | 機密混入、権限超過、意図しない外部送信 | ツール拡張、テスト運用の本番混入 | 監査ログと入力DLPが前提になる |
実務判断向けの比較軸は次の通りです。
| 比較軸 | 確認すること | 実務上の意味 |
|---|---|---|
| 検知速度 | 症状発現から検知までの時間 | 影響拡大を抑えられるかに直結する |
| 切り分け粒度 | どの層に原因があるか特定できるか | 誤った切り戻しを避けられる |
| 復旧手段 | 切り戻し・縮退・機能停止のどれを持つか | 業務継続の柔軟性が変わる |
| 事後レビュー | 変更履歴と再現手順が残っているか | 再発防止に接続できる |
プレイブックは文書化しないと形骸化します。運用開始時に、次の項目を担当と頻度まで含めて決めます。
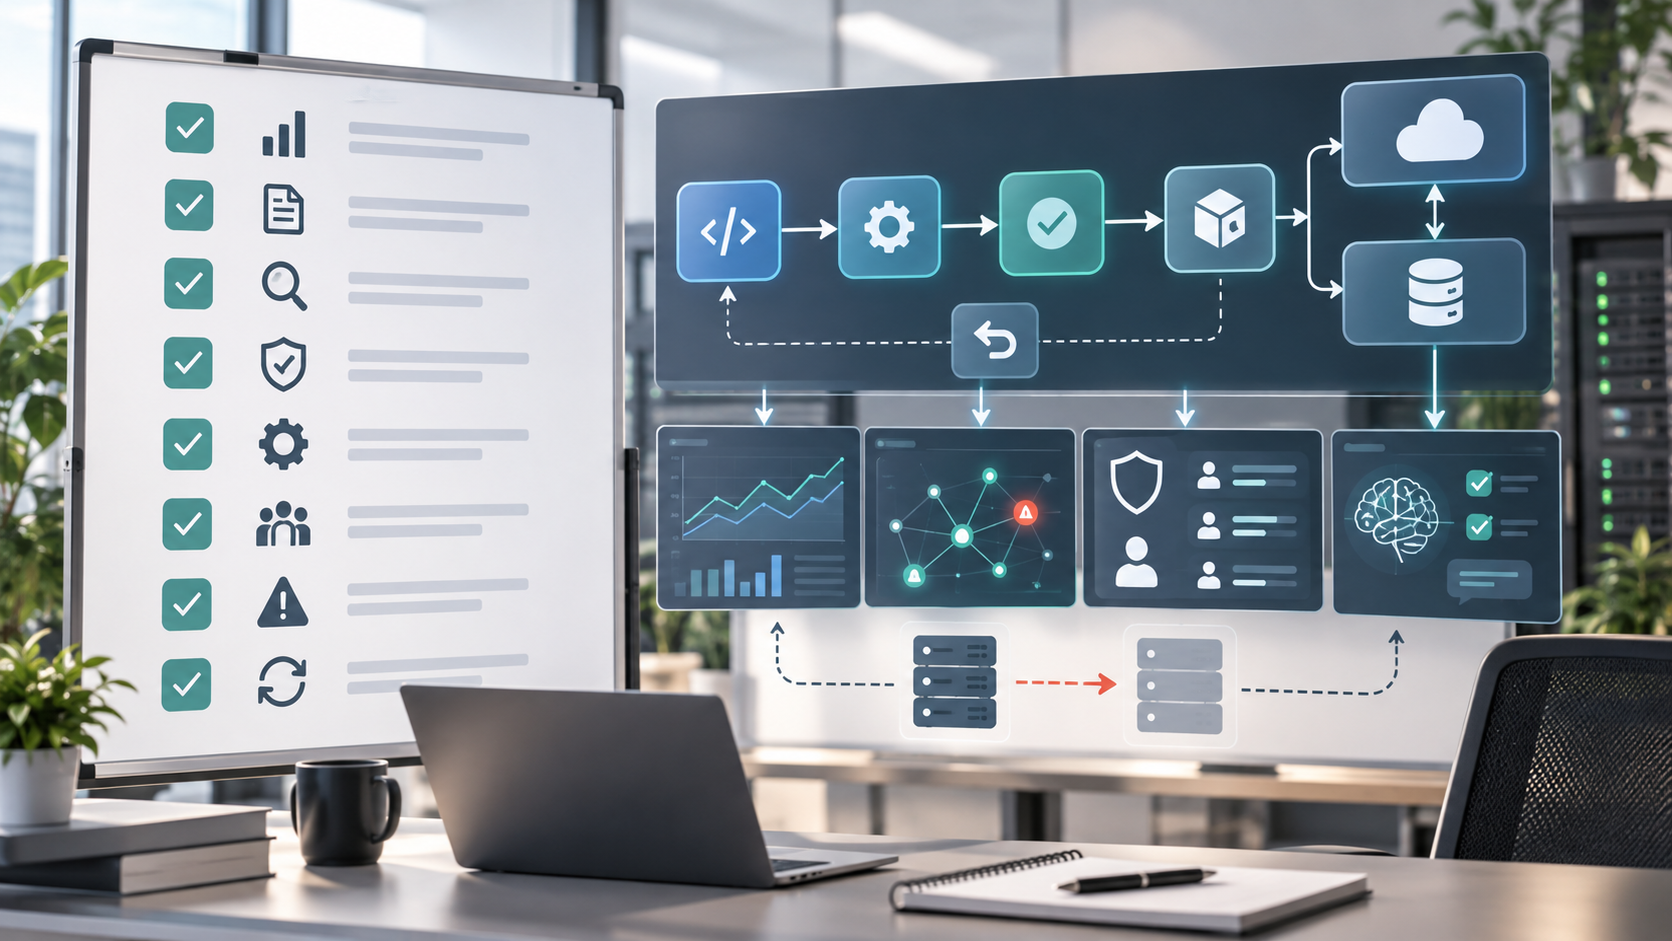
導入前チェックリスト:
運用開始後に見る指標:
原因層の推定は、次の順で回すと迷走しにくくなります。
プレイブックは万能ではありません。次の条件では、無理に自動化・標準化せず、業務側と合意した縮退運用に寄せます。
撤退基準の例:
LLMインシデント対応は、単発の障害対応ではなく、データ基盤・クラウド構成・業務プロセスと接続して初めて機能します。
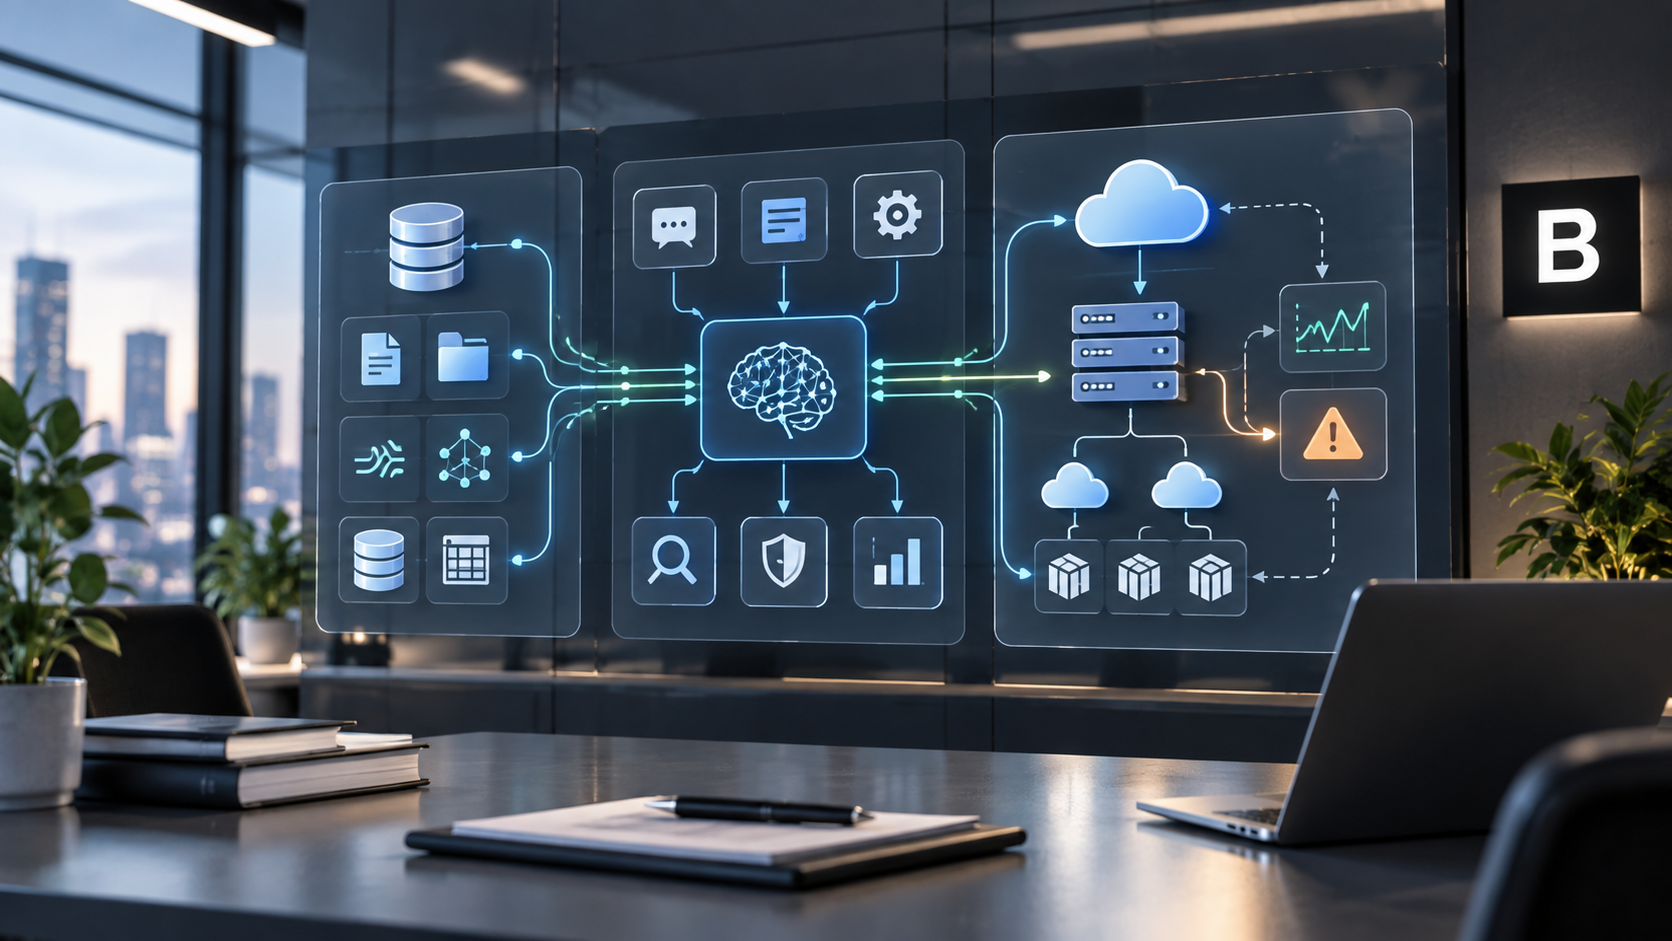
Blackford Technologiesは、AI戦略の整理から実装、本番運用までを一気通貫で支援する立場から、次の観点を重視しています。
社内ナレッジやRAGの参照データを扱う場合は、DataRoidやDataRoid Cloudで参照データの版管理とアクセス制御を運用ループの一部として設計する選択肢もあります。導入後の伴走運用と改善提案を組み合わせる場合は、AI導入後の運用・改善で障害対応体制の整備までまとめて相談できます。
関連する運用論点は、LLMアプリのロールアウト戦略やLLMアプリのSLO設計、LLMアプリの予算ガードレール設計もあわせて確認してください。
コードが変わらなくても品質が変動する点です。ベンダーのモデル更新、参照データの変更、入力分布の変化が引き金になるため、切り分けはモデル・プロンプト・参照データ・実装の4層で行います。1指標だけでは撤退判断せず、幻覚率や修正率と合わせて見ることが前提になります。
まずは判断表と切り戻し先の1枚に絞って始めます。障害分類、初動アクション、担当者、切り戻し先の4項目だけでも、事故時の初動精度は大きく上がります。運用に慣れてから、縮退モードや事後レビューの型を足す進め方で十分です。
ゴールデンデータセットに対するオフライン評価と、本番ログのサンプリング人間レビューの2系統で計測します。1指標だけでは撤退判断せず、修正率・否認率と合わせて見ることが前提です。データの持ち方や評価者の運用は、監査ログとあわせて先に設計しておきます。
軽量モデルへの切替、参照データを限定、ツール呼び出しの停止、応答テンプレートの固定などを組み合わせます。業務側と合意した「最低限の応答」を残せる構成を用意しておくことが要点です。切替判断は自動化する前に、当直担当と業務側で承認フローを合意しておきます。
アクションを担当・期限・確認指標まで書き切ることが不足しがちです。ポストモーテムのアクションが「監視指標のどの改善で完了とみなすか」を明記し、次の運用ミーティングでレビューする流れにすると定着しやすくなります。
LLM本番運用のインシデント対応は、コード修正の作業ではなく、モデル・プロンプト・参照データ・実装を4層で切り分ける運用設計です。判断表、切り戻し先、縮退モード、事後レビューの4点を先に決めることで、事故の被害と復旧時間を大きく下げられます。
自社の運用体制で「どの層まで切り戻し先を持つか」「何を撤退基準にするか」を決めきれない場合は、業務課題と評価指標の整理から相談してみてください。
\LLM本番運用の設計を相談できます/
Blackfordに相談する




