
社内文書を生成AIに繋いだRAG(検索拡張生成)が本番業務に入ると、「モデル選び」より「文書権限を検索段階で守れるか」が情報漏洩リスクの分岐点になります。SharePointや基幹システムから資料を取り込むほど、権限の付け替えを検索側で吸収できるかが問われます。
一方で、権限を厳しく閉じすぎると、AIが十分な情報を引けず業務効果が出ません。この記事では、社内RAGの権限継承モデル、実装・運用で確認すべき項目、導入前チェックリストを整理します。
社内文書を生成AIに繋いだRAG(検索拡張生成)が本番業務に入ると、「モデル選び」より「文書権限を検索段階で守れるか」が情報漏洩リスクの分岐点になります。SharePointや基幹システムから資料を取り込むほど、権限の付け替えを検索側で吸収できるかが問われます。
一方で、権限を厳しく閉じすぎると、AIが十分な情報を引けず業務効果が出ません。この記事では、社内RAGの権限継承モデル、実装・運用で確認すべき項目、導入前チェックリストを整理します。
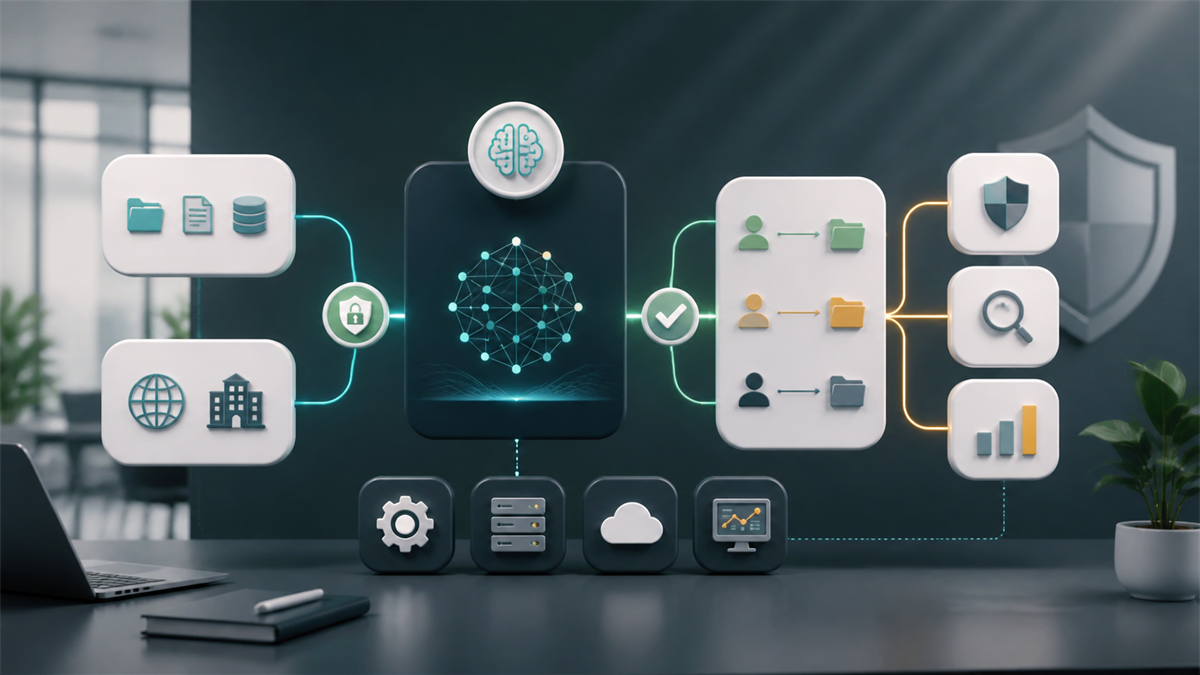
社内RAGの権限管理で最初に見るべき指標は、次の3点です。
| 読者の課題 | 最初に見る指標 | 確認すること | 次の行動 |
|---|---|---|---|
| 見えてはいけない資料が回答に混ざる | 権限フィルタの適用位置 | 検索の候補生成前で絞れているか | ベクトル検索の絞り込みを見直す |
| 権限変更が反映されない | 元システムとの同期頻度 | 削除・失権が即時に効くか | 権限メタデータの再同期を設計する |
| 誰が何を引いたか分からない | 監査ログの粒度 | 質問・引用元・回答が紐付くか | 検索・回答ログを一元管理する |
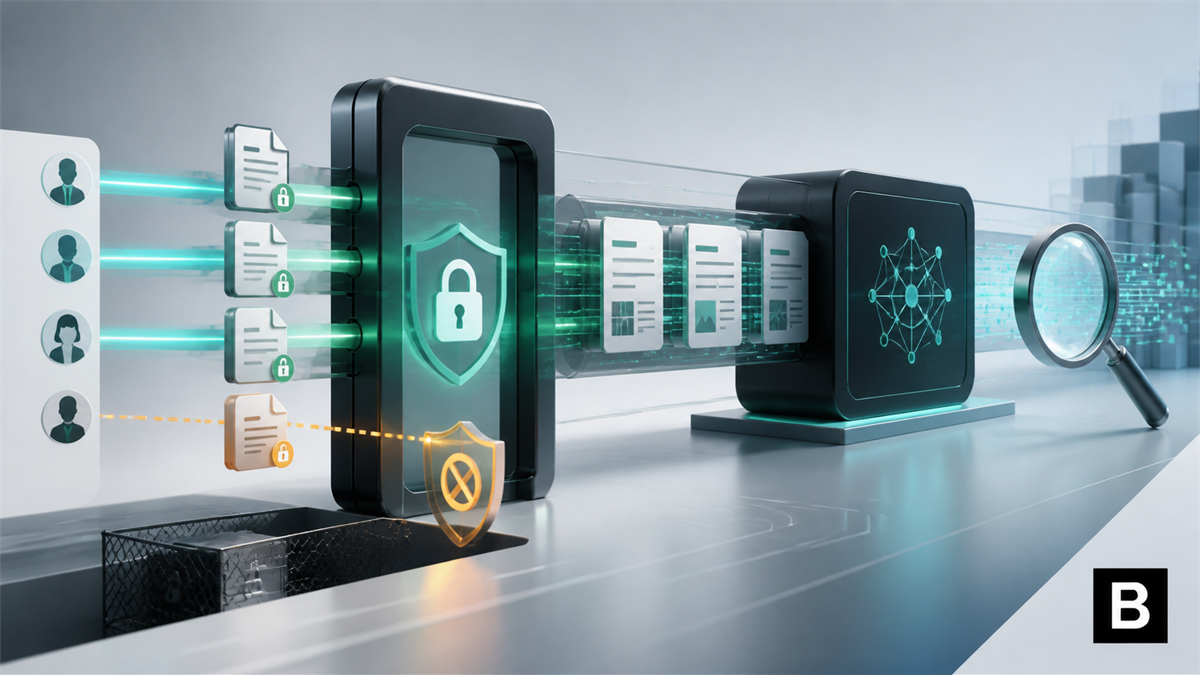
「回答文をあとから隠す」設計にすると、モデルは既に見た情報を要約できてしまいます。検索の候補生成の前で、ユーザー権限に応じて文書を除外することが原則です。
※RAGツールやAI基盤の料金、データ保持条件、提供機能は変更される場合があります。導入前に公式情報で最新条件を確認してください。
先に、本記事で使う用語を短く整理します。
| 用語 | 意味 |
|---|---|
| RAG | 社内文書をAIが検索・引用しながら回答する仕組み |
| チャンク | 文書を分割した検索単位。数百〜数千文字が目安 |
| ベクトル検索 | 意味の近さで文書を探す検索方式 |
| 権限継承 | 元文書のアクセス権を検索側でもそのまま使うこと |
| メタデータ | チャンクに付与する属性。所属部門や権限も入る |
RAGは「検索」と「生成」を組み合わせるため、権限管理も検索と生成の両方に効かせる必要があります。
生成AIによる社内検索は、便利さと情報漏洩リスクが表裏一体です。とくに次の変化が同時に進んでいます。
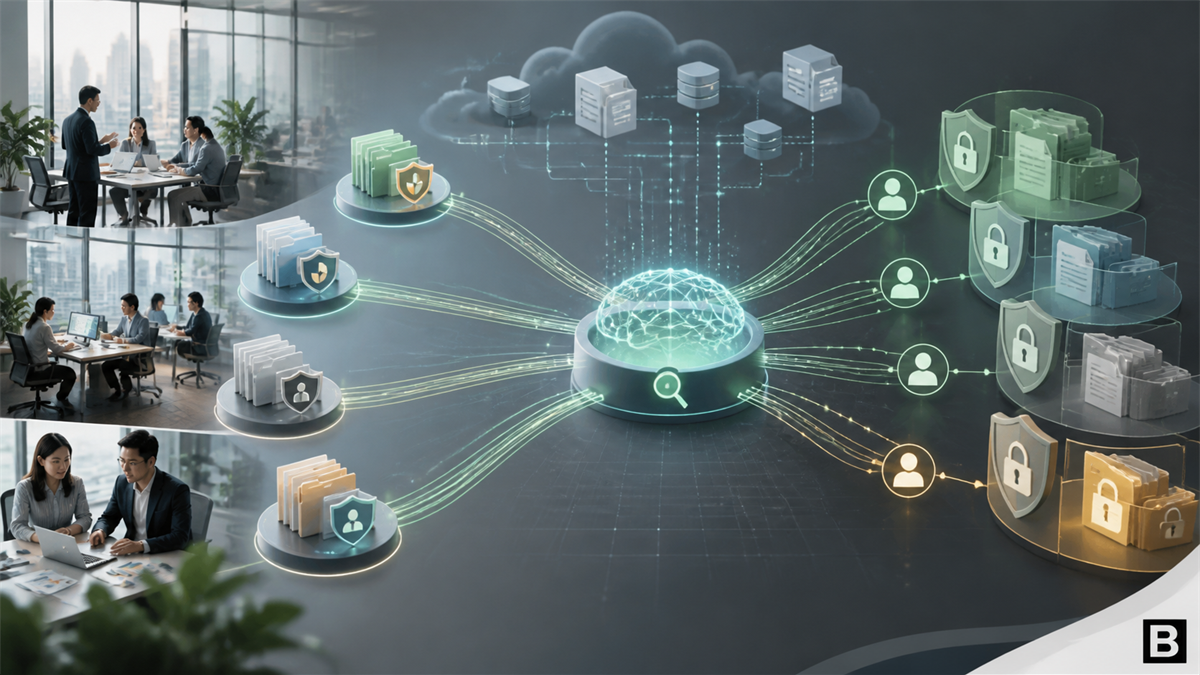
権限管理を後から足すのは難しい仕組みです。ベクトル検索の設計を変えることになり、再インデックスや監査ログ再構築が必要になります。最初から「検索の前で権限を効かせる」設計にしておくことが、後戻りのコストを抑える鍵です。
社内RAGでよく使われる権限モデルを、まず概要で並べます。
| 方式 | 一言でいうと | 向くケース | 注意点 |
|---|---|---|---|
| 文書単位継承 | 元文書のACLをチャンク全体に適用する | 資料が部門単位で分離されている | 文書内に強い機密節がある場合は不十分 |
| チャンク単位継承 | チャンクごとに独自の権限を持てる | 契約書・議事録など章ごとに機密度が違う | 権限メタデータの設計と保守が重い |
| 動的評価 | 検索時に外部の認可サーバへ問い合わせる | 権限が頻繁に変わる、監査要件が厳しい | 検索遅延と外部依存に注意 |
次に、実務判断向けの比較を示します。
| 比較軸 | 確認すること | 実務上の意味 |
|---|---|---|
| 権限の粒度 | 部門・役職・案件・行単位のどこまで守るか | 機密資料が回答に混ざるリスクを左右する |
| 同期頻度 | 元システムでの権限変更が何分で反映されるか | 退職・異動時の即時失権に直結する |
| 監査ログ | 質問・引用元・回答を紐付けて保存できるか | 情報漏洩発生時の追跡と再発防止に効く |
| 検索遅延 | 権限評価が検索1回あたり何ミリ秒か | 業務ツールとしての実用性に影響する |
| 例外運用 | 特別権限、緊急閲覧、監査モードの扱い | 内部統制・監査対応の設計に関わる |
小規模から始める場合は文書単位継承で構いません。ただし、契約書・人事資料・監査資料など、章単位で機密度が違う文書を扱うなら、チャンク単位継承への拡張余地を残す設計にします。
社内RAGを本番に載せる前に、次の観点を担当者ベースで詰めます。
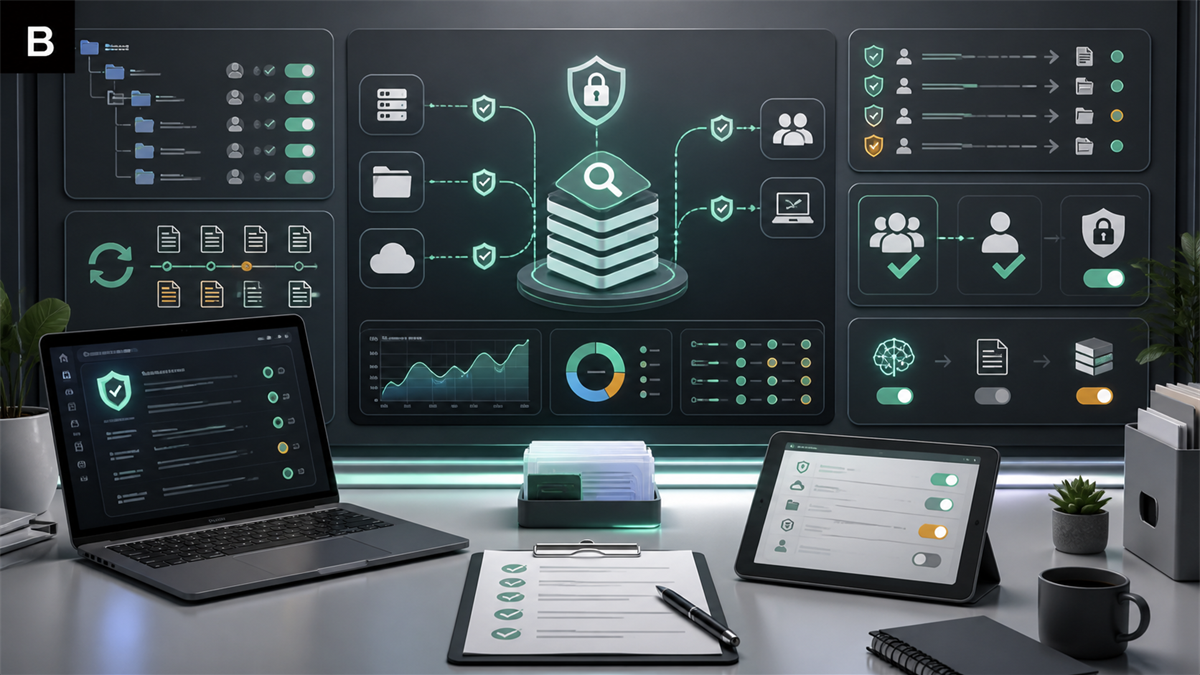
これらは、AIエージェントの権限設計(AIエージェントの権限管理とアクセス制御設計)とも接続します。エージェント経由でRAGを呼ぶ場合は、両者の権限モデルを一致させます。
社内RAGの権限継承は、次の限界を前提に運用します。
これらは、LLMアプリケーションのランブックと障害対応やLLMアプリケーションのCI/CDテスト戦略と組み合わせて、定期的な棚卸しと回帰テストで抑えます。
注意 権限継承は「完全な情報漏洩対策」ではありません。生成AIは学習・推論の性質上、断片情報からの推測を完全に防げません。運用ガイドラインとログ監査を併用し、扱う情報の範囲を段階的に広げます。
Blackford Technologiesは、AI戦略の整理から本番運用までを一貫して支援します。社内RAGの権限継承は、モデル選定や検索アルゴリズムより、データ基盤側の権限メタデータ設計と同期パイプラインで9割が決まると考えています。
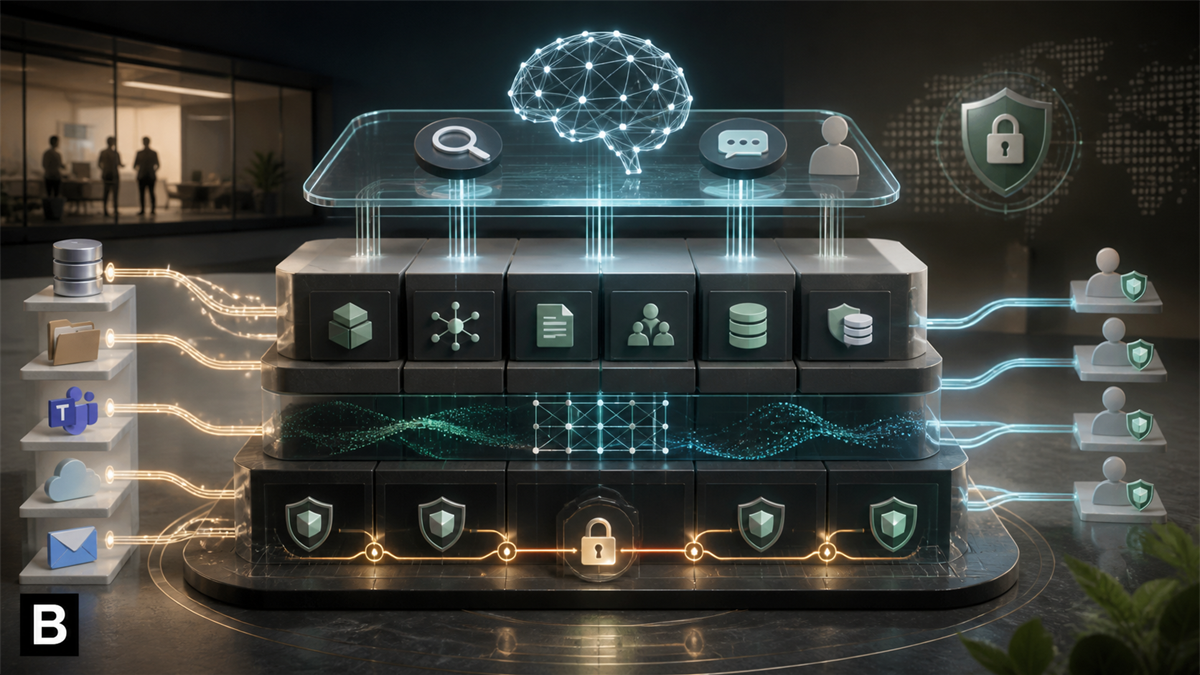
私たちが実務で見ているのは、次の順序です。
DataRoidは、社内データをAIが扱える形に整える基盤です。権限継承を含めたナレッジ検索、要約、分類、異常検知、ワークフロー自動化までを支援します。
既存クラウド資産を活かして段階導入したい場合は、DataRoid Cloudを組み合わせます。営業・商談・顧客対応のRAGは、SalesRoid側の営業プロセス設計と連動させると、権限と業務フローが揃います。
Q. 社内RAGの権限管理は、通常のファイル共有と何が違いますか? A. 検索の段階で権限を効かせる必要がある点が違います。ファイル共有はUIで表示を制御しますが、RAGはAIが要約・引用するため、権限のないチャンクを検索候補にした時点で漏洩リスクが生まれます。候補生成の前でフィルタする設計が原則です。
Q. 小さな組織でも権限メタデータを設計する必要はありますか? A. 扱う資料に機密情報や個人情報が含まれるなら、規模を問わず必要です。少人数でも、契約書・人事資料・顧客情報などは部門や役職で閲覧を分けます。まずは文書単位継承から始め、機密度の高い資料だけチャンク単位に切り替えます。
Q. 権限変更はどれくらいで反映されるべきですか? A. 退職や異動で即時失権が求められる情報は、数分以内の反映を目標にします。契約書や人事資料が対象なら、権限同期を1日1回のバッチにするのは避けます。動的評価方式や、権限メタデータのイベント同期を検討します。
Q. 監査ログはどこまで残すべきですか? A. 質問、引用元、回答、権限フィルタの結果を紐付けて残すのが基本です。ただし、ログ自体が機密情報の集積になるため、保存期間、閲覧権限、暗号化、削除ポリシーも同時に決めます。監査要件と情報保護要件を両立させます。
社内RAGは、ナレッジ活用の生産性を大きく上げる仕組みです。ただし、権限継承の設計を後回しにすると、情報漏洩リスクと運用負荷が急激に増えます。
まず、扱うデータの機密区分と閲覧範囲を先に決めます。次に、権限メタデータを検索の候補生成前で効かせる設計にし、監査ログと変更同期を最初から用意します。モデル選定や検索精度の改善は、その上で進めるほうが手戻りが少なくなります。
自社での社内RAG導入に迷う場合は、業務課題・扱うデータ・既存システムの権限モデルを整理したうえで、専門家に相談しましょう。
\社内RAG・ナレッジ検索の設計を相談できます/ Blackfordに相談する




