
LLMアプリは、通常のWebサービスと同じテスト感覚では品質を守れません。プロンプト変更やモデル切替による品質劣化は、本番投入後に初めて気づきがちです。
CI/CD(継続的インテグレーションと継続的デリバリー)にLLM特有の評価ステップを組み込むことが、回避策の中心になります。
本記事では、LLMアプリ向けの自動テスト戦略を、テスト階層・CI/CDへの組み込み方・運用後の見直し手順として整理します。
LLMアプリは、通常のWebサービスと同じテスト感覚では品質を守れません。プロンプト変更やモデル切替による品質劣化は、本番投入後に初めて気づきがちです。
CI/CD(継続的インテグレーションと継続的デリバリー)にLLM特有の評価ステップを組み込むことが、回避策の中心になります。
本記事では、LLMアプリ向けの自動テスト戦略を、テスト階層・CI/CDへの組み込み方・運用後の見直し手順として整理します。
LLMアプリのテスト・CI/CD設計を始めるための論点を扱います。
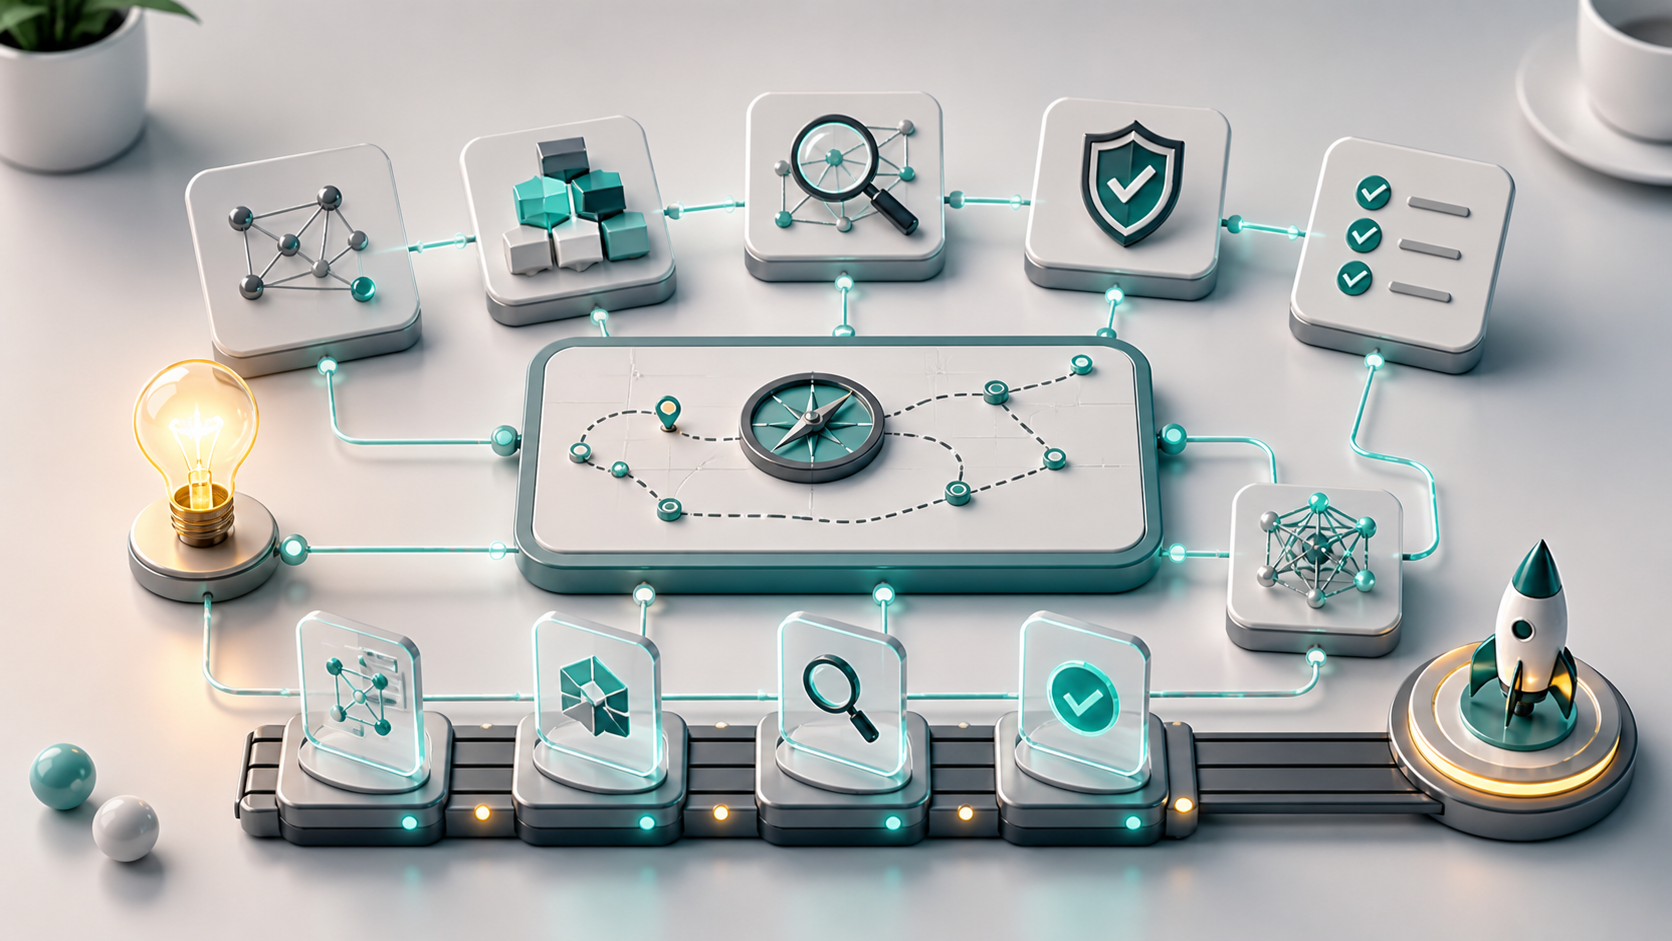
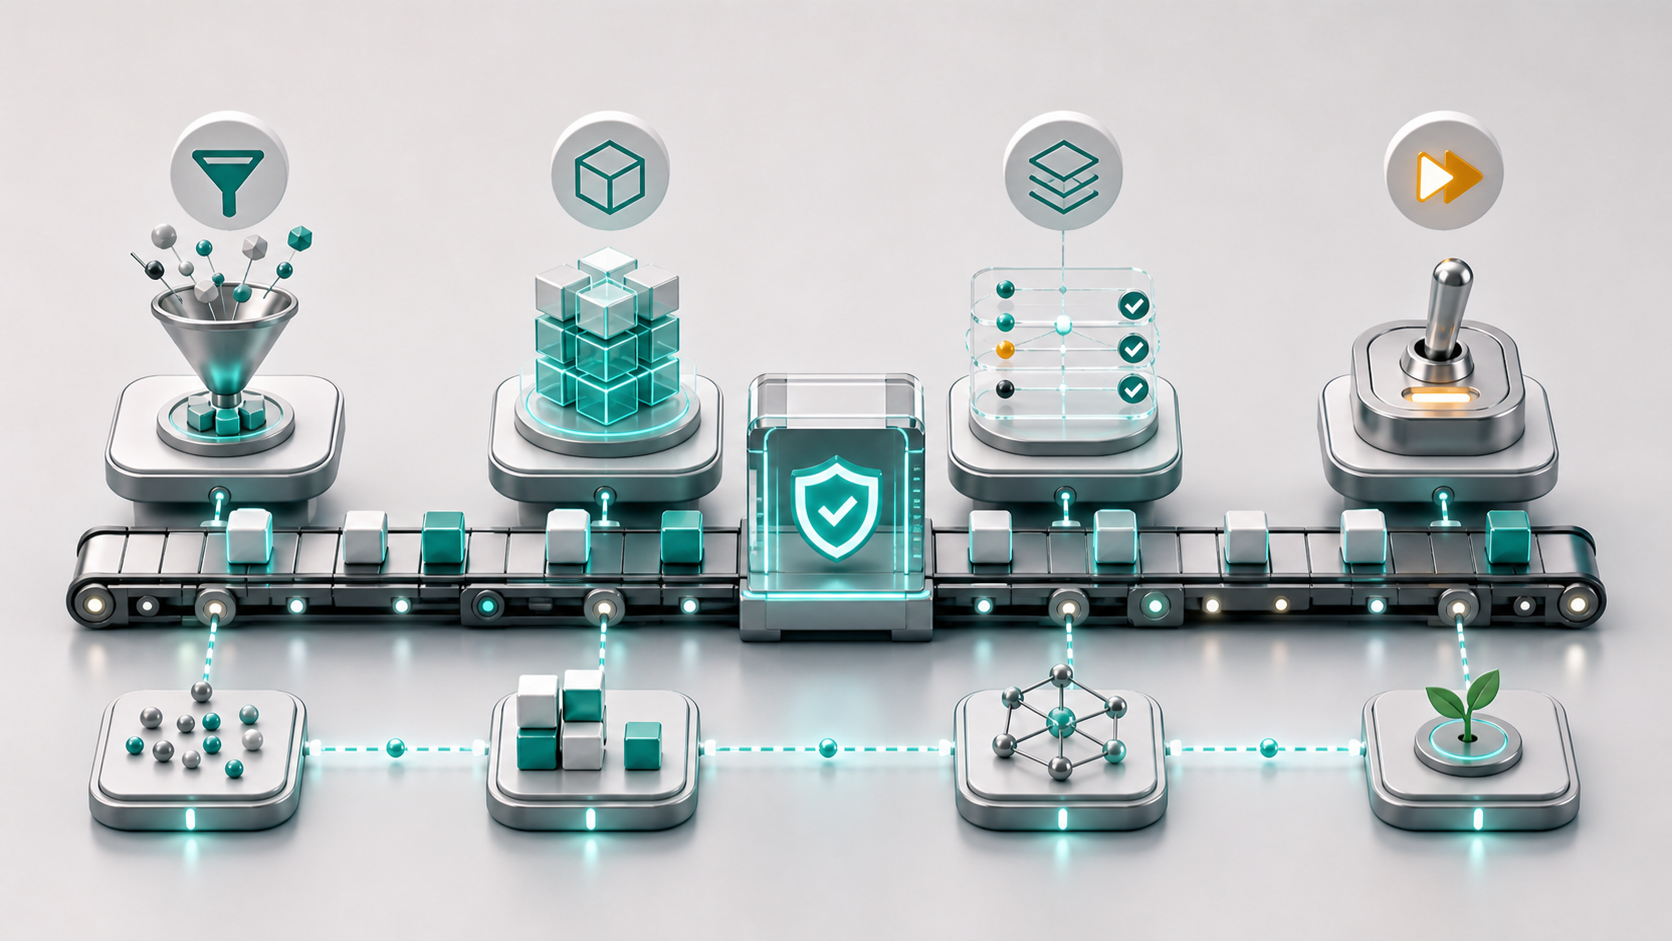
LLMアプリのCI/CDは、通常のテスト2階層(ユニット・統合)に、評価層と本番監視層を足した4階層で設計します。
| テスト階層 | 何を見るか | 確認すること | 実行タイミング |
|---|---|---|---|
| ユニットテスト | コード単体の挙動 | 後処理・パース・ガードレールの正しさ | コミット時 |
| 統合テスト | LLM呼び出しを含む処理経路 | API契約、エラー処理、リトライ | PR作成時 |
| 自動評価 | プロンプト・モデルの出力品質 | 正答率、ユースケース別品質、回帰 | PRマージ前 |
| 本番監視 | 運用中の品質と劣化 | オンライン評価、ユーザーフィードバック | 常時 |
3層目の自動評価が抜けると、CIが緑でも本番で品質が落ちます。一方、全リクエストで自動評価を実行するとコストが膨らみます。
評価対象と実行頻度の設計が、LLMアプリCI/CDの中心です。
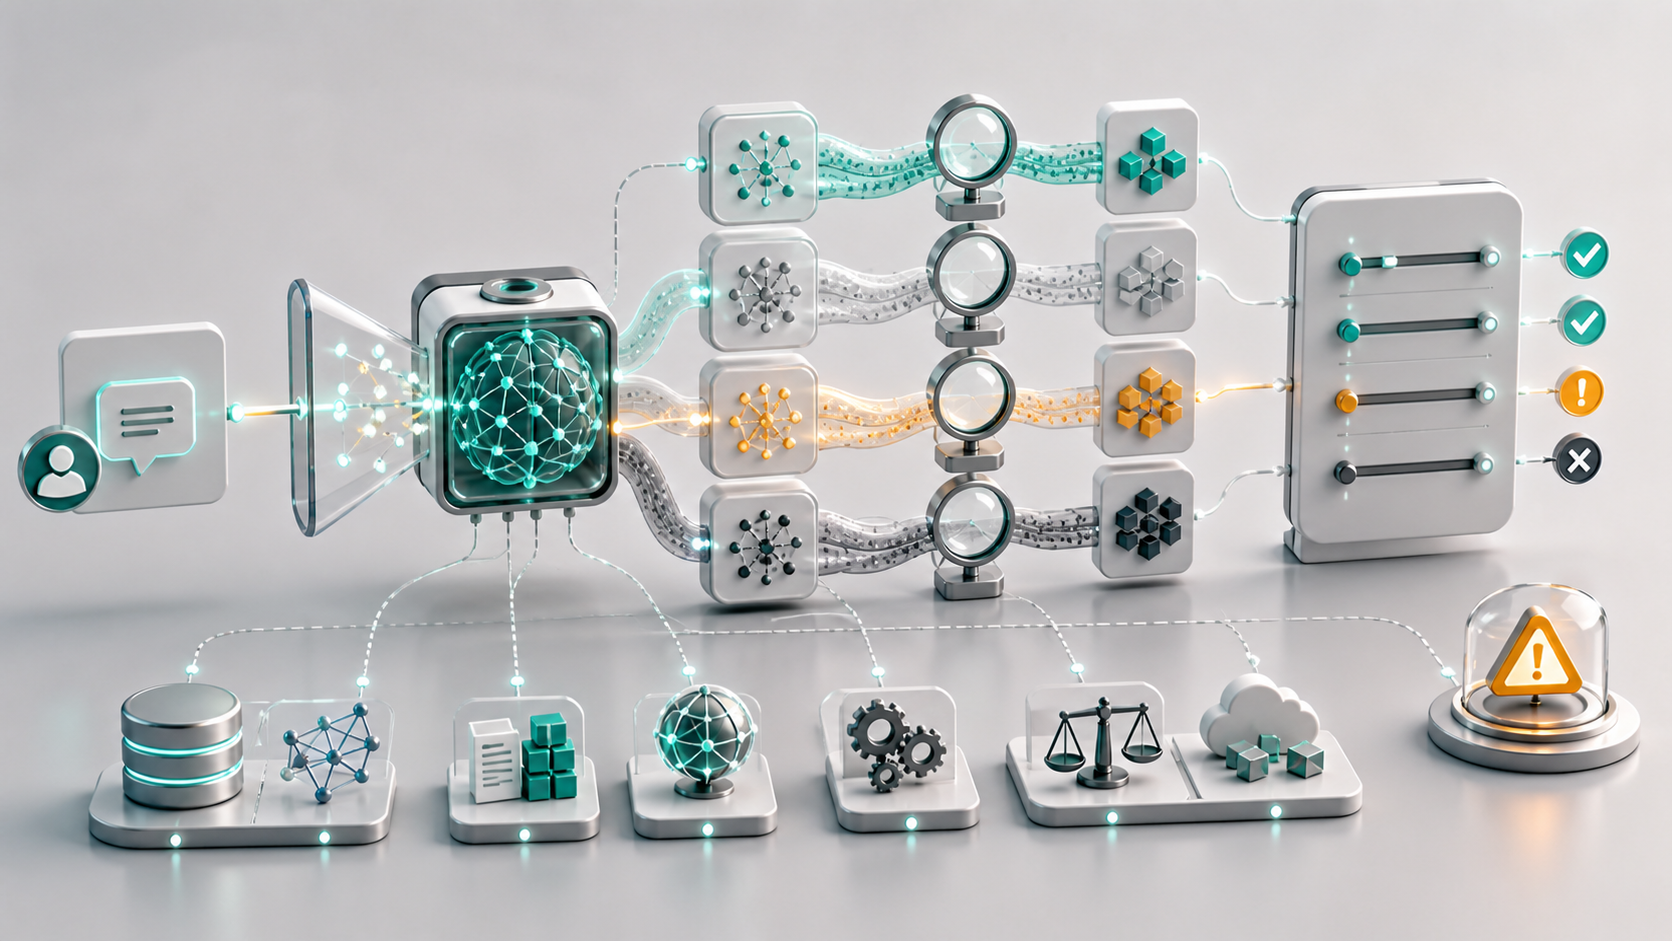
通常のWebアプリのテストは「同じ入力には同じ出力」を前提にします。LLMアプリは、この前提が成り立ちません。
| 観点 | 通常Webアプリ | LLMアプリ |
|---|---|---|
| 出力の決定性 | 決定的 | 確率的(同じ入力でも揺れる) |
| 期待値 | 完全一致または明確な仕様 | 「許容範囲」のため自動判定が難しい |
| テストコスト | 軽量、再現性が高い | API課金、再現性が低い |
| 回帰検知 | 静的解析と単体テスト | 評価データセットでの比較が必要 |
このため、LLMアプリには次の3つを新しく入れます。
これらをCI/CDに組み込むことで、人手レビューだけに頼らない仕組みになります。
| 用語 | 意味 |
|---|---|
| CI/CD | コード変更を自動でテスト・配信する開発運用の仕組み |
| ゴールデンデータセット | 正解例と期待要件を集めた評価用データ |
| LLM-as-a-judge | LLM自身に出力品質を採点させる評価手法 |
| 回帰テスト | 過去に通った内容が新版で壊れていないかを確認するテスト |
| エラーバジェット | 許容できる失敗量。SLO運用の基本単位 |
LLMアプリは、コード変更とプロンプト変更が同時に走ります。プロンプト変更はコード変更より頻度が高く、影響範囲が見えにくいのが特性です。
特有の難しさは次の3つです。
CI/CDに自動評価がないと、これらは本番投入後にユーザー報告で気づきます。気づくのが遅いほど、原因の切り分けが難しくなります。
特にプロンプト変更は、コードレビューで品質を判断しにくい領域です。「読んで良さそう」と「本番で品質を保つ」の差は、評価データセットでしか測れません。
プロンプトの版管理そのものはLLMアプリのプロンプト版管理で扱っています。本稿はその版管理を、CIパイプラインの自動評価に接続する話です。
各階層は、決定的な検証と確率的な検証を切り分ける役割を持ちます。階層の境目を決めると、コストとカバレッジのバランスが議論できるようになります。
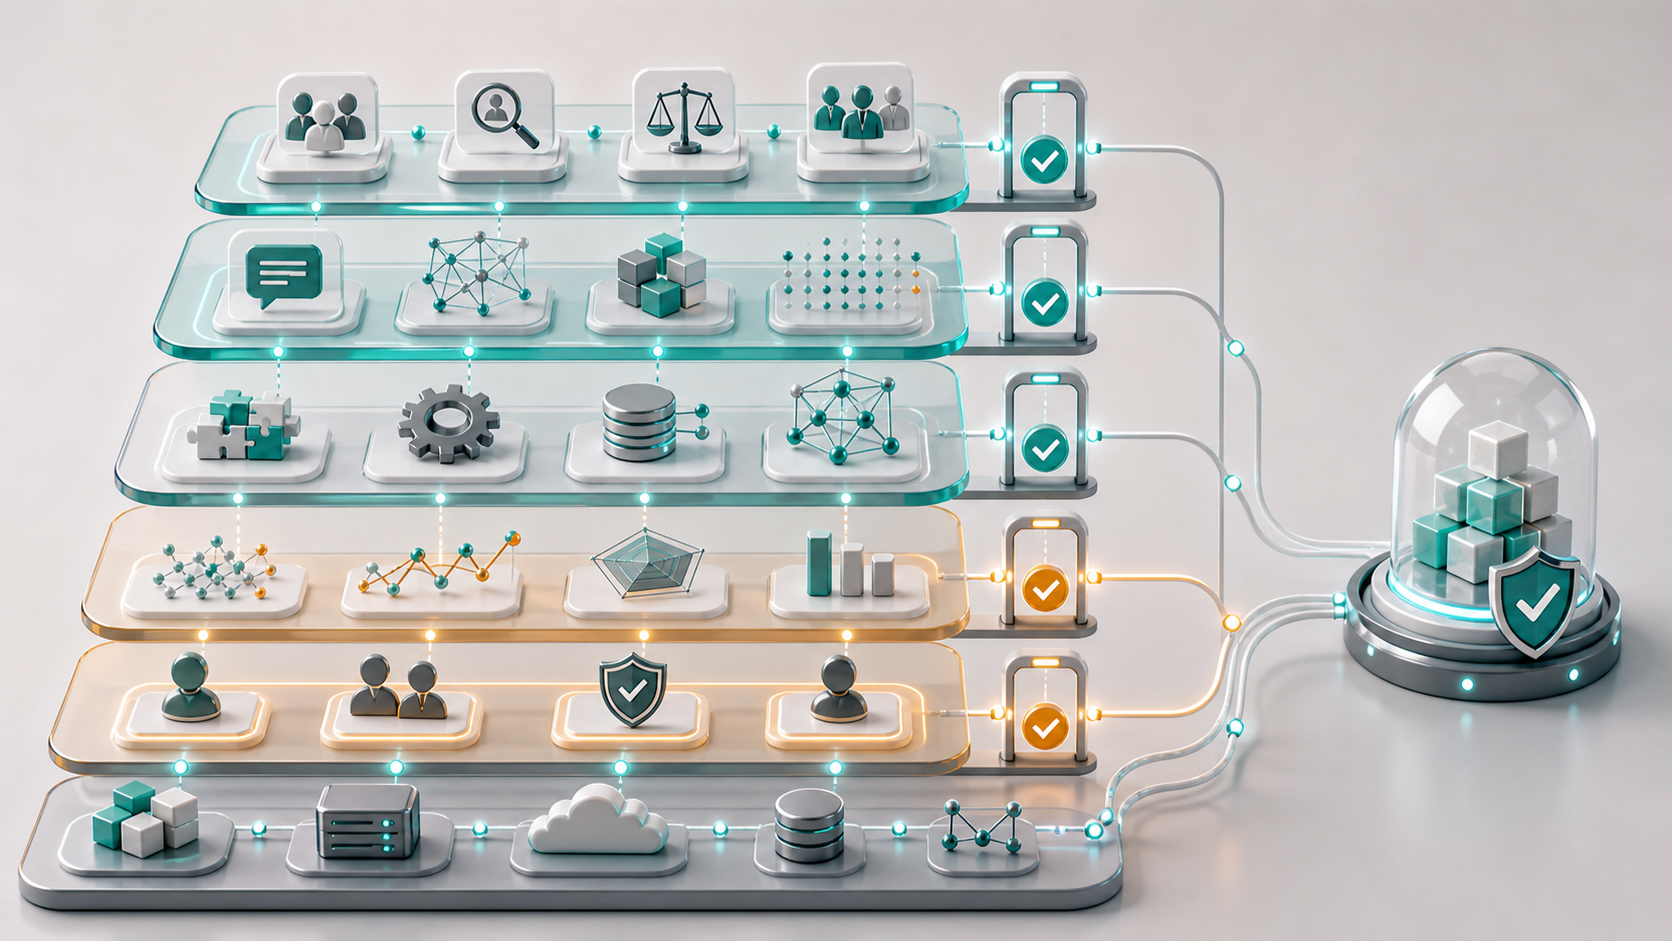
対象は、LLMを呼ばないコード部分です。後処理、JSONパース、ガードレール、リトライ判定、データ変換などを単体で確認します。
LLMを呼ばないため、決定的・高速・無料です。「LLMアプリだから単体テスト不要」は誤りで、LLM呼び出しの周辺コードこそ単体テストの恩恵が大きい領域です。
LLM呼び出しを含む処理経路を確認します。実APIを使うか、モックを使うかは目的で分けます。
| 方式 | 一言でいうと | 向くケース | 注意点 |
|---|---|---|---|
| 実API呼び出し | 本物のAPIで挙動を確認 | エラー処理、リトライ、レイテンシ検証 | コスト発生、再現性が低い |
| モック応答 | 固定応答を返す擬似API | パース・後処理・分岐の検証 | モデル挙動の変化は捕捉できない |
| 録画再生 | 過去応答を保存して再生 | 高速で再現性の高い検証 | 録画の鮮度管理が必要 |
3方式を組み合わせ、全部を実APIで回さない設計にします。
ゴールデンデータセットで、プロンプトとモデルの出力品質を測ります。CI/CDの中で「前回より品質が◯%以上落ちていないか」を判定します。
最小構成のゴールデンデータセットは、次の3点を満たします。
評価指標は、用途で選びます。
| 指標 | 何を測るか | 向くケース |
|---|---|---|
| 完全一致率 | 期待出力と一致するか | 構造化出力、JSON生成 |
| LLM-as-a-judge | LLMが品質を採点 | 自由記述、要約、対話 |
| ルールベース判定 | 含むべき語・避けるべき語 | 規約遵守、用語の使い分け |
| 人手レビュー比率 | サンプル抽出で人が確認 | 重要意思決定、対外発信 |
評価コストとカバレッジのバランスは、後述のCIパイプライン設計で扱います。
CI/CDで品質を確保しても、本番ではユーザー入力の分布が変わります。オンライン評価とユーザーフィードバックを併用し、運用中の品質劣化を捕まえます。
CIで全件カバーするのは不可能なため、本番監視は「CIで見ない種類の入力」を見つける役割を持ちます。
評価ステップをCIに組み込む際の判断は、次の順で進めます。
タイミングは、コストとリードタイムで決めます。
| タイミング | 実行内容 | 想定コスト | 想定実行時間 |
|---|---|---|---|
| コミット時 | ユニットテスト、リント | ほぼ無料 | 数十秒 |
| PR作成時 | 統合テスト(モック・録画中心) | 低 | 数分 |
| PRマージ前 | 自動評価(ゴールデンデータセット) | 中(API課金) | 数分〜数十分 |
| リリース前 | 拡張評価、回帰確認、サンプル人手レビュー | 中〜高 | 数十分〜数時間 |
PR作成時に毎回フル評価を回すと、コストとリードタイムが膨らみます。マージ前に集約し、リリース前にもう一度厚めに回す配分が現実的です。
評価ステップを入れる前に、次を文書として残します。
これらが揃わないと、評価ステップが「赤になっても無視される」状態になります。
LLMの自動評価は、油断するとAPI課金が無視できない額になります。コストを抑える打ち手は次の4つです。
LLM-as-a-judgeは強力ですが、コストとレイテンシの負担が大きい指標です。全評価項目にLLM-as-a-judgeを使わず、ルールベース判定で済むものは分離します。
評価コストは、SLOの一部としても管理します。LLMアプリの可用性・レイテンシ・コスト目標の整理はLLMアプリのSLO設計で扱っています。
CIに評価を組み込んでも、データセットと閾値を放置すると形骸化します。最低限、次を四半期で見直します。
| 指標 | 何のために見るか |
|---|---|
| ゴールデンデータセットのカバレッジ | 主要ユースケースを取りこぼしていないか |
| 評価失敗の検知件数 | 本番不具合の何割をCIで捕まえられたか |
| 評価コスト | 月次上限内に収まっているか |
| 評価実行時間 | 開発リードタイムへの影響 |
| 本番ユーザーフィードバック | CIで見えなかった失敗種別 |
本番で見つかった不具合のうち、CIで捕まえられなかったものは、再発防止のためにゴールデンデータセットへ追加します。これが、評価とCI/CDをつなぐ運用ループの中心です。
評価データセットを「育てる」発想は、評価・監視の全体像と一体で運用すると効果が高まります。詳しくはLLM評価・モニタリングの実践を参照してください。
CI/CDに自動評価を組み込んでも、次の限界があります。
次のいずれかに当てはまる場合は、最小構成のスプレッドシート評価でも構いません。
業務利用が定着し、変更頻度が上がってから自動化に移行するのが現実的です。
※本記事の整理は2026年6月時点のLLMOpsとCI/CD実務知見に基づきます。LLM関連サービスの料金、データ保持条件、提供機能は変更される場合があります。導入前に公式情報で最新条件を確認してください。
LLMアプリのCI/CD設計は、評価データを「業務知識として育てる」発想が中心です。Blackford Technologiesは、AI戦略の整理からPoC設計、実装、本番運用までを一貫して支援します。
特に、次の論点をセットで整理することを推奨します。
評価データセットは、LLMアプリの「業務知識の言語化」そのものです。データ基盤と切り離して設計すると、ゴールデンデータの管理者が不明、ログが残らない、という状況になりがちです。
社内ナレッジやRAG運用での評価設計はDataRoidが選択肢になります。既存クラウドやVPC内で運用する場合はDataRoid Cloud、営業領域のLLM活用はSalesRoidが候補です。
LLMアプリのCI/CD・自動評価設計はAI開発・実装サービスで支援しています。評価データセットの設計から、相談ベースで始められます。
通常テストは「同じ入力に同じ出力」を前提にしますが、LLMは確率的に揺れるためその前提が成り立ちません。ユニット・統合テストに加え、ゴールデンデータセットによる自動評価と本番監視を組み合わせる4階層設計が必要です。評価指標と閾値判定をCIに組み込むことが起点になります。
最初は主要ユースケースを20〜50件ずつカバーする規模で十分です。完全網羅より、失敗影響の大きい業務を優先します。運用後に「本番で見つかった失敗例」をデータセットへ追加することで、評価カバレッジが業務知識として育っていきます。
なります。全件LLM採点ではなく、変更影響範囲に絞る、ルールベース判定との併用、評価用に軽量モデルを使う、PRマージ前のみ実行するなどを組み合わせます。評価コストは月次上限を決めて、SLOの一部として管理することを推奨します。
モデル切替は、ゴールデンデータセットの再ベースライン取得を必ず行います。新旧モデルで同じデータを評価し、ユースケース別の品質差を見ます。全体平均は同等でも、特定業務で大きく落ちることがあるためです。切替判断は、A/Bテストやカナリーリリースとの組み合わせで行います。
ゴールデンデータセット20件、ルールベース判定中心の自動評価、PRマージ前の評価実行、四半期見直しの4点があれば始められます。ツールは既存CI(GitHub Actions等)に乗せ、評価結果はスプレッドシート出力でも問題ありません。本格的な評価基盤は、運用が安定してからで十分です。
LLMアプリのCI/CD設計は、ユニット・統合テストにゴールデンデータセットによる自動評価層と本番監視層を足した4階層が起点です。確率的な出力に対しては、完全一致だけでは品質を担保できないためです。
ただし、評価ステップは入れて終わりではありません。評価コスト、データセットの鮮度、検知失敗の振り返りを四半期で見直し、評価データを業務知識として育てる発想が必要です。
自社のLLMアプリで「どこまで自動化し、どこから人手で見るか」を整理したい場合は、業務影響、評価データ、運用責任者を棚卸しした上で、専門家に相談しましょう。
\LLMアプリのCI/CD・評価設計を相談できます/
Blackfordに相談する




