この記事でわかること
- 論文「Stealing Reasoning Traces from Proprietary LLM APIs」が示した推論トレース抽出の脆弱性
- 「セッション間互換」を突く4つの攻撃ベクトルと数値根拠
- 公開ログ315,320件から復元されたPII367件・認証情報182件の意味
- クラウドLLM APIを社内で使う企業が短期に確認すべき運用点
- VPCや閉域推論への切り替え判断で見るべきチェックリスト
3つの要点
- 提案: ある強いモデルの暗号化推論ブロックを、同一ベンダーの弱いモデルに渡すと平文推論として復元される「解読ジェイルブレイク」を実証しました。
- 改善: Anthropic・OpenAI・Googleを横断して4つの攻撃ベクトルを再現し、公開ログ315,320件から367件のPIIと182件の認証情報を復元したと論文アブストラクトは報告しています。
- 実務: クラウドLLMを社内利用する企業は、推論ブロックを含むログ共有の運用と、閉域・単一モデル運用への切り替え条件を再点検する必要があります。
従来の前提:暗号化ブロックはブラックボックスで安全とみなされていた
主要ベンダーは、推論トレースを守るためにクライアント側へ暗号化ブロックを返す設計を採用してきました。この設計は、モデル資産の保護と情報漏えい抑制を狙ったものです。
論文が指摘する前提の弱さは次の通りです。
- 暗号化ブロックは「読めないから安全」と扱われがち
- 実際にはブロックが同一ベンダーの複数モデルで交換可能
- クライアントはブロック内容を検査できず、共有しても内容を把握できない
- 開発者は会話ログの公開時に、暗号化部分に何が含まれるかを確認できない
多くの開発者はデバッグ目的でセッションログをGitHub等に貼り、その中に暗号化ブロックが含まれるケースがあります。読めない前提のまま公開されていた点が、後述の大量PII復元に直結しています。
提案する攻撃:解読ジェイルブレイクと4つの攻撃ベクトル
論文の攻撃は、モデル自身を直接ジェイルブレイクせずに、暗号化ブロックの互換性を突く点が特徴です。
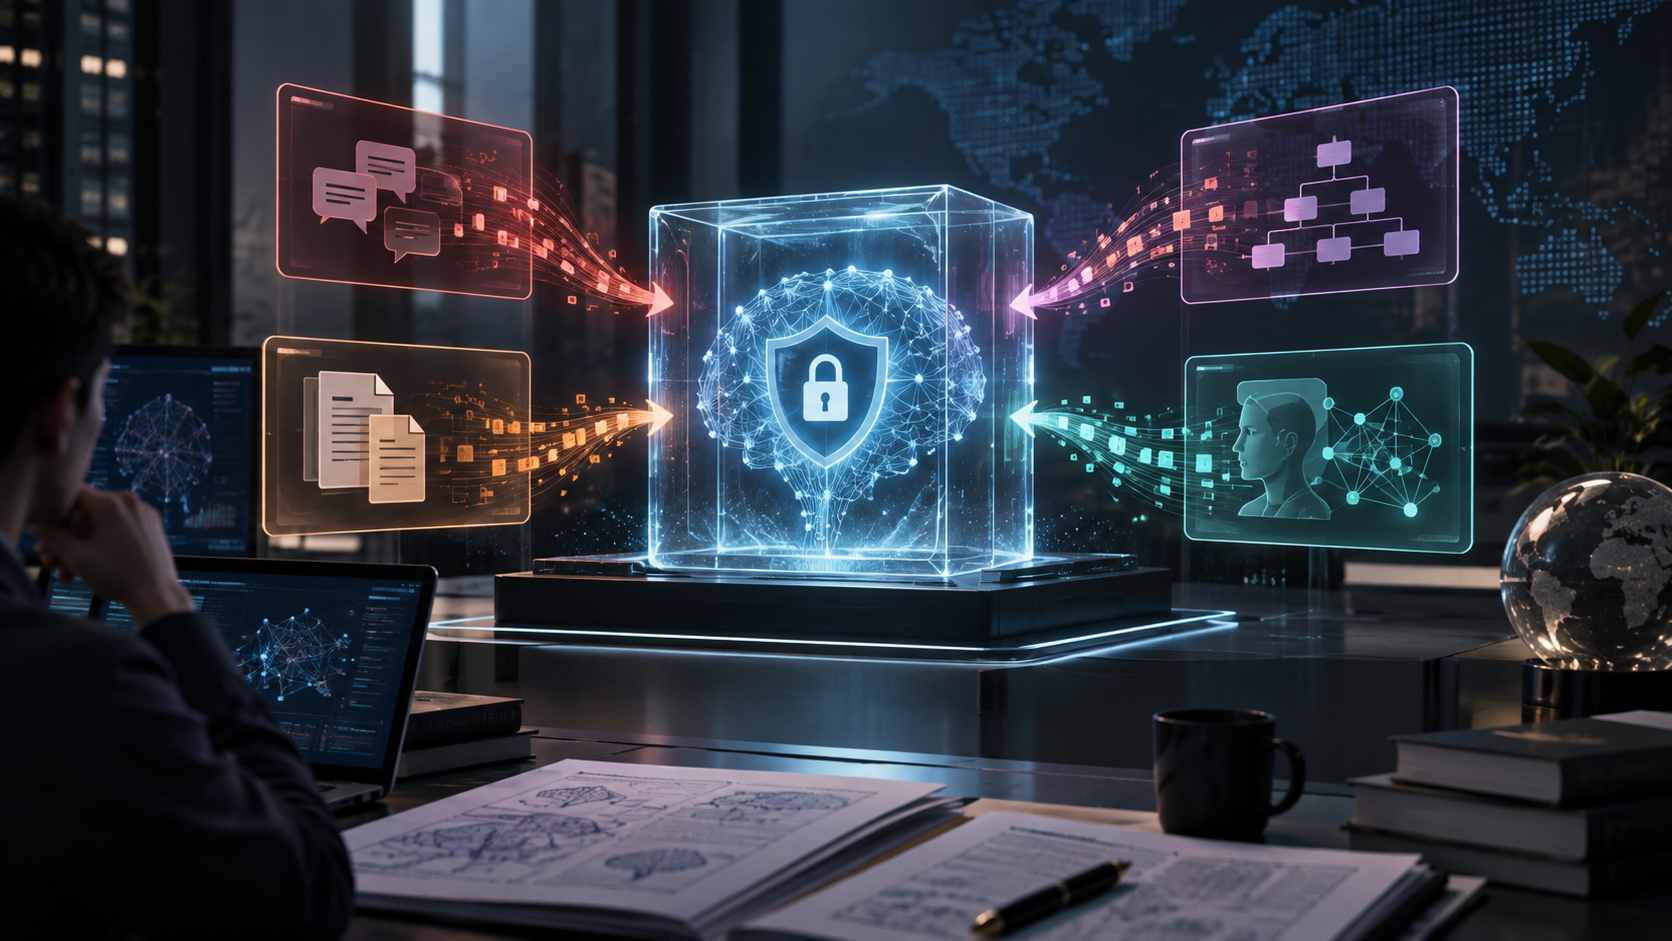
直感は、上位モデルの「推論の器」を、監視の緩い下位モデルに丸ごと差し込み、下位モデル側で平文を吐かせる動きです。上位モデル側の安全策を迂回しつつ、下位モデル側でも新規に危険入力を渡していないため、既存の入出力フィルタが反応しにくい構造です。
技術要点は次の3点に整理できます。
- 同一ベンダー内で、暗号化ブロックの復号鍵とフォーマットが共有されている
- 弱いモデルに暗号化ブロックを注入すると、内容を再解釈して平文で出力する
- 攻撃者はプロンプト側を汚さず、暗号化ブロック側に指示を仕込める
論文はこの解読ジェイルブレイクを土台に、次の4つの攻撃ベクトルを提示しました。
| 攻撃ベクトル |
何が起きるか |
実務上の読み方 |
| 反蒸留の迂回 |
強モデルの推論を平文で抽出 |
モデル資産保護前提が崩れる |
| 大規模PII抽出 |
公開ログ経由で個人情報が復元 |
開発者ログ共有ポリシー要見直し |
| 危険情報の漏出 |
最終出力は安全でも推論内に有害情報 |
出力監査だけでは不十分 |
| 見えないプロンプト注入 |
暗号化ブロックに攻撃指示を埋込 |
エージェントの公開ロールアウトが汚染源に |
実験結果:315,320ブロックから367件のPIIと182件の認証情報
論文は攻撃を単なる可能性で終わらせず、実データで規模感を示しました。
主要な検証結果は次の通りです(数値はいずれも論文アブストラクトに基づく)。
- Anthropic・OpenAI・Googleの3社で解読ジェイルブレイクを再現
- 公開リポジトリから収集した推論ブロック315,320件を復号
- 復元結果から個人識別情報(PII)367件を抽出
- 同じデータから認証情報(クレデンシャル)182件を復元
読み方の要点は、「攻撃の理論値」ではなく「既に公開されているログから復元できた実測値」である点です。過去に共有されたログは削除しても第三者の手元に残るため、暗号化前提が崩れると遡って露出します。
比較の観点も整理します。
| 比較軸 |
従来の想定 |
論文が示す実態 |
| 暗号化ブロックの中身 |
クライアントには読めない |
同一ベンダー内の下位モデルで復元可 |
| 攻撃の必要条件 |
強モデルの直接ジェイルブレイク |
弱モデルへの単純注入で十分 |
| 出力監査での検知 |
最終応答をフィルタすれば足りる |
推論内に隠れる有害情報を見逃す |
| 開発者ログの取扱い |
匿名化すれば公開可 |
暗号化部分に生情報が残り得る |
限界と注意点:ベンダー横断で対策済みか随時確認する
論文の適用範囲と限界も明示します。
- 対象は主要3ベンダーの特定時点のAPI実装で、修正状況は継続確認が必要
- 攻撃は「同一ベンダー内」で成立し、異ベンダー間では検証対象外
- 復元されたPIIや認証情報の内訳は個別サービスごとに変わり得る
- 論文は責任ある開示を経ており、報告後の対策適用状況はベンダー発表が一次情報
実務側で注意すべきは、脆弱性の有無だけでなく、過去に共有された推論ブロックが第三者の手元に残っている前提で運用を組み直す必要がある点です。
未検証領域も明示しておきます。
- 各社が採用した対策の相互運用(複数モデル切替時の後方互換)
- オンプレ・VPC提供モデルにおける同種攻撃の成立条件
- エージェント公開ロールアウトが汚染された場合の連鎖範囲
実務への示唆:クラウドLLM運用の再点検チェックリスト
企業がクラウドLLM APIを社内で使う場合、次の観点で運用を見直す価値があります。
- 推論ブロックを含むセッションログを、社外に共有していないかを棚卸しする
- 過去に公開したログについて、暗号化部分の内容を把握できないと明記する
- 出力監査だけでなく、推論プロセス側の監査要件をベンダーに確認する
- 同一ベンダー内でモデルを切り替える運用のリスクを設計に反映する
- 機微データを扱う用途では、VPCや閉域配備の選択肢を再評価する
「クラウドLLMを社内でも使い続けるか」「機微用途は閉域に寄せるか」の判断分岐点は、暗号化前提の信頼度に依存します。信頼できない期間だけでも、機微データを含むワークロードは切り離す運用が現実的です。
短期・中期の対応も分けて考えます。
- 短期: セッションログ共有ポリシー、匿名化手順、監査ログ範囲の再点検
- 中期: 機微データを扱う経路を、VPC・専用テナント・オンプレ推論に分離
- 長期: マルチベンダー戦略と、ベンダーの暗号化・開示ポリシーの継続評価
Blackfordの見解:暗号化ブロック前提の運用は「性善説」から降りる
Blackfordは、社内AIとクラウドLLMを組み合わせる企業に向けて、暗号化推論ブロックを「読めないから安全」と扱う前提を降りることをおすすめします。
論文が示したのは、単一の脆弱性ではなく、クライアント側で不透明な暗号化資産を運用する設計そのものが持つリスクです。API側の修正は進んでも、過去に流通したブロックは戻せません。
実務では、次の優先順位で棚卸しを進めるのが現実的です。
- まず「機微データが推論に載る経路」を業務単位で洗い出す
- 次に「その経路が公開・社外共有される可能性」を確認する
- 最後に「切り替え先のVPC・専用テナント・オンプレ選択肢」を評価する
社内データ基盤と機微用途の切り分けは、DataRoid Cloudのような閉域AIプラットフォームで、経路単位の設計が組みやすくなります。制度対応や監査要件を含む個別の判断は、お問い合わせから相談してください。
よくある質問
Q1. この脆弱性はすでに修正されていますか?
論文は責任ある開示を経ており、対策も提示していますが、各社の適用状況は継続確認が必要です。過去に共有された推論ブロックは第三者に残っているため、修正されても遡及的な影響は残ります。
Q2. 自社が使っているAPIも影響を受けますか?
論文はAnthropic・OpenAI・Googleを対象に実証しました。他ベンダーが同じ設計を採用している場合は理論上同様のリスクが成立し得ますが、個別の影響有無はベンダーの一次情報で確認してください。
Q3. まず何から手を付けるべきですか?
セッションログの社外共有ポリシーの棚卸しから始めるのが現実的です。次に、機微データを扱う用途を特定し、VPCや専用テナントへの切り離しを検討します。
Q4. VPCや閉域なら安全ですか?
論文の攻撃は同一ベンダーの共通ブロック互換性を前提としています。閉域配備は攻撃面を減らしますが、同種の設計を用いる限りリスクの完全な排除は保証されません。運用要件と一致するかをベンダーに確認する必要があります。
まとめ
「Stealing Reasoning Traces from Proprietary LLM APIs」は、暗号化推論ブロックの互換性を突く抽出攻撃を、Anthropic・OpenAI・Google横断で実証しました。論文アブストラクトが示す通り、公開ブロック315,320件から367件のPIIと182件の認証情報が復元された事実は、理論的リスクではなく実測値としての深刻さを示します。
企業がクラウドLLM APIを使う場合、暗号化ブロックを「読めないから安全」と扱う運用は見直しが必要です。まずセッションログ共有ポリシーと機微データの経路を棚卸しし、必要に応じてVPC・専用テナント・オンプレ推論への切り離しを進めるのが現実的です。
自社の運用要件と論文の指摘を突き合わせる作業は、業務単位の棚卸しから始めるのが有効です。
なお、本記事の論文情報は2026年9月24日時点のarXiv公開ページに基づき記載しています。
Blackfordに相談する