この記事でわかること
- LLM多言語運用で最初に決めるべき3層とその優先順位
- プロンプトを言語ごとに分けるか、共通にするかの判断軸
- 日本語以外の言語で評価データを揃える現実的な進め方
- 監査ログとデータ主権を言語・地域ごとに扱う際の注意点
- 採用しないほうがよい多言語運用のパターン
結論サマリー:多言語運用の判断表
まず自社の状況から、最初に手をつけるべき層を選んでください。
| 読者の課題 |
最初に見る指標 |
確認すること |
次の行動 |
| 英語出力の品質が読めない |
言語別の正答率と幻覚率 |
英語の評価データが揃っているか |
言語別の評価データセットを作る |
| 翻訳経由か直出力か迷う |
直出力の理解精度と翻訳誤差 |
用途別に品質差が測れているか |
用途別に方式を分けて評価する |
| 地域ごとに法務要件が違う |
データ保持先とログの言語 |
地域別に監査ログが分かれているか |
地域別ログとアクセス権を分ける |
| 言語ごとにコストがぶれる |
言語別1リクエストコスト |
言語別のトークン量とキャッシュ率 |
言語別のコスト計測を先に整える |
多言語運用は「プロンプト分離→言語別評価→地域別監査」の順で段階的に固めるのが失敗しにくい進め方です。
LLM多言語運用とは何を指すのか
LLM多言語運用は、機械翻訳を後付けする話ではありません。同じLLMアプリを複数言語で使うときに、次の3層を運用として組み立てる取り組みです。
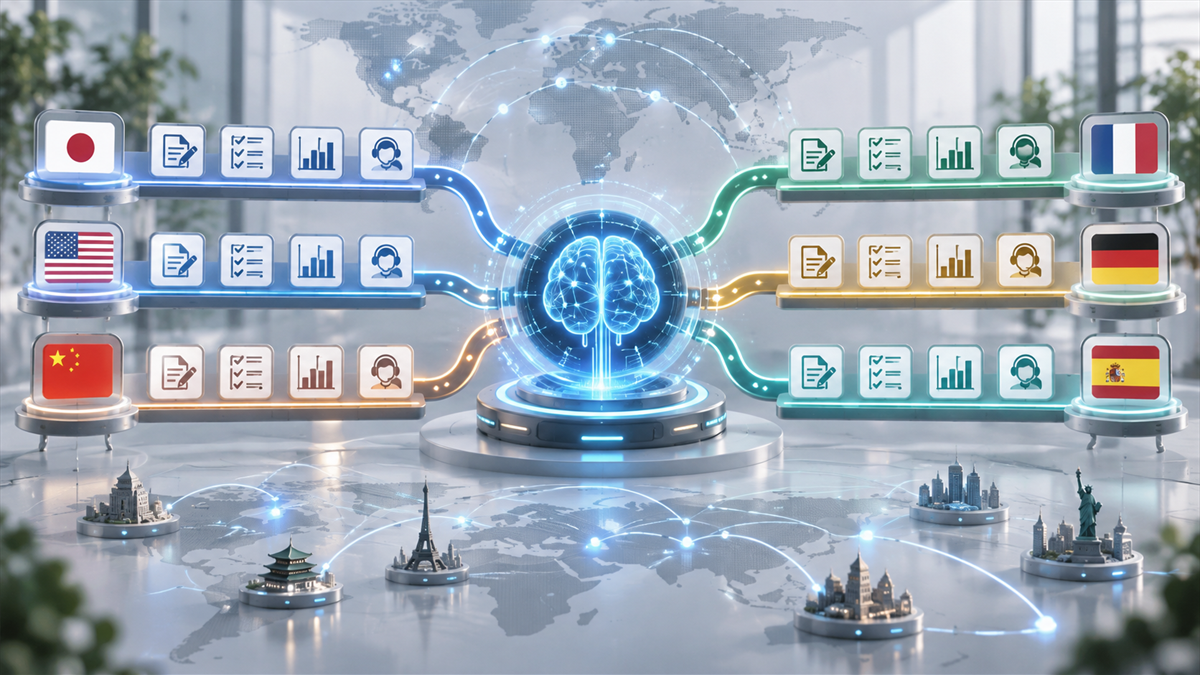
- プロンプト管理:言語ごとの指示文とテンプレート、共通ロジックの分離
- 評価と監視:言語別の正答率・幻覚率・ユーザー修正率の計測
- 監査とデータ主権:地域・言語別のログ、権限、データ保持の設計
用語が多くなるため、本文前半で使う語を先に整理します。
| 用語 |
意味 |
| ロケール |
言語と地域の組み合わせ。表記や単位、法制度の違いを含む |
| プロンプトテンプレート |
変数を差し込む前提の再利用可能な指示文 |
| ゴールデンデータセット |
期待する出力例を集めた評価用データ |
| データ主権 |
データが特定の国・地域の法律の下で扱われる状態 |
| データ最小化 |
業務に必要な最小限のデータだけを扱う設計方針 |
なぜ2026年後半に多言語運用の設計が重要なのか
日本企業のLLM活用が日本語中心のPoCから、海外拠点や多国籍顧客対応へ広がる時期に入っています。急務な理由は次の4つです。
- 東南アジアや欧米の拠点でLLM活用が始まり、日本語運用のまま横展開する事例が増えた
- 生成AI関連の規制対応が地域ごとに分岐し、監査要件の言語・地域切り分けが求められる
- 主要LLMの多言語性能は改善しているが、業務ドメインでは言語間の品質差が残る
- 翻訳と直出力の使い分けを決めないと、月次コストと品質のどちらも読めなくなる
※LLM関連サービスの料金、データ保持条件、提供機能は変更される場合があります。導入前に公式情報で最新条件を確認してください(情報確認日:2026年9月12日)。
多言語運用の3層と判断軸
多言語運用を組み立てる3層は、独立に設計せず、上の層から順に判断していきます。
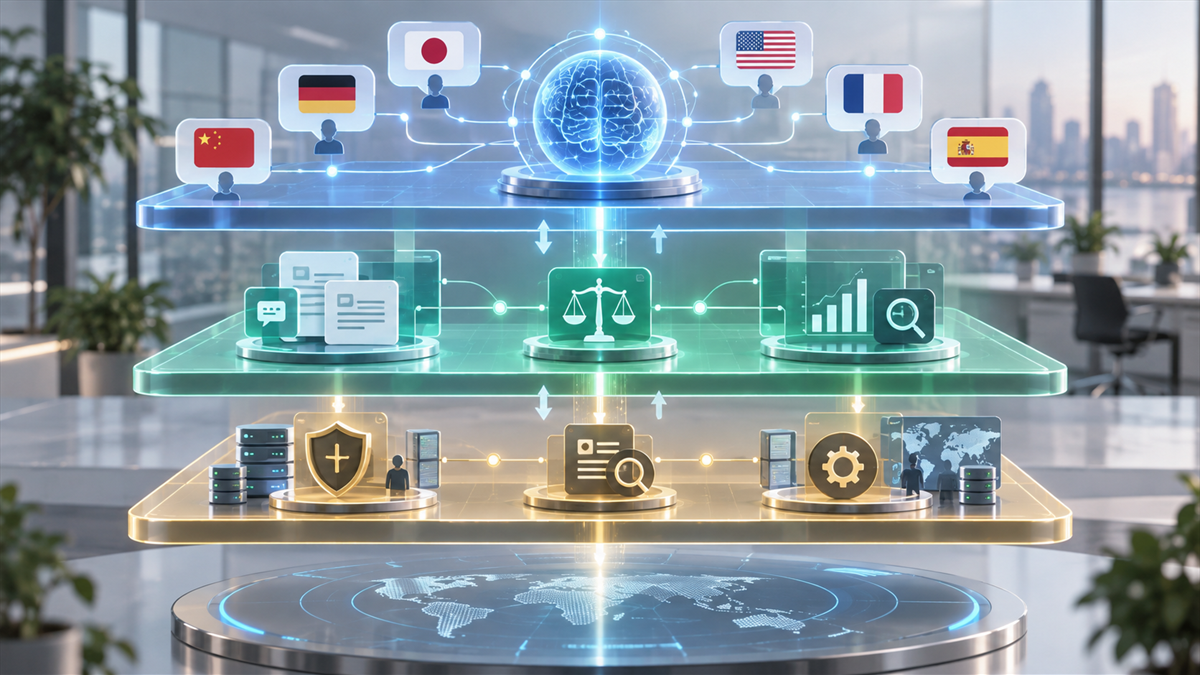
| 層 |
一言でいうと |
向くケース |
注意点 |
| プロンプト管理 |
言語ごとの指示文と共通ロジックを分ける |
業務が同じで言語だけ違うアプリ |
分けすぎて保守負荷が増える |
| 評価と監視 |
言語別に品質と失敗を計測する |
業務クリティカルな出力を扱うとき |
評価データを日本語だけで作ると偏る |
| 監査とデータ主権 |
地域・言語別にログと権限を切る |
越境データ制約や規制対応がある業務 |
集約ログの言語混在で監査効率が下がる |
判断軸は、次の順で整理します。
| 比較軸 |
確認すること |
実務上の意味 |
| ユーザー言語 |
入力・出力に必要な言語と地域 |
プロンプト・UIをどこまで分けるかの起点 |
| 業務ドメイン |
契約、医療、金融など専門性 |
直出力か翻訳経由かの判断に効く |
| 品質許容度 |
誤読・誤配信の許容水準 |
評価データ整備の優先度に効く |
| 規制と主権 |
データ保持先、監査、越境移転 |
地域別ログ設計と権限分離に効く |
| コスト構造 |
言語別トークン量、キャッシュ、モデル選択 |
月次費用の増加要因の特定に効く |
プロンプト管理を言語ごとにどう分けるか
言語ごとに完全に別プロンプトを作ると、業務ロジックの変更が多重管理になります。分離の基準を先に決めておきます。
- 業務ロジックとメッセージ本文を分け、変数と条件分岐は共通化する
- 言語ごとの表現・敬語・呼称・単位・日付表記はテンプレート層で差し替える
- 用語辞書と業界固有語は言語別の外部ファイルに切り出す
- 生成後の後処理(丁寧語、フォーマット、法的注意文)は言語別に定義する
- 変更履歴とレビュアーを言語ごとに割り当て、変更影響を評価データで確認する
「翻訳して同じ指示を渡す」だけで済ませると、日本語で通っていた指示が英語で意図と異なる挙動をすることがあります。翻訳品質より、テンプレート層で言語ごとに書き分ける発想を優先します。
言語別評価データを揃える現実的な進め方
日本語で作ったゴールデンデータセットを機械翻訳しただけでは、言語別評価としては不十分です。実運用に耐えるデータの揃え方は次の順です。
- 業務クリティカルな用途を先に絞り、そこから他言語版を用意する
- 各言語で50〜200件の代表ケースを社内レビュー付きで作る
- 機械翻訳したケースは「参考データ」に留め、評価スコアの本線には使わない
- 現地拠点や現地パートナーに用語の妥当性を確認するプロセスを組む
- 幻覚率、業務語の誤用、法的表現の誤りを言語別に集計する
言語ごとに指標を出しにくい場合は、まず「幻覚率」と「用語誤用率」の2つに絞ります。全指標を揃えるより、業務判断に効く指標を早期に立ち上げるほうが有効です。
監査ログとデータ主権を地域・言語別に扱う
地域ごとの規制と契約要件は、ログ設計に強い影響を与えます。監査で使えるログ設計の要点を整理します。
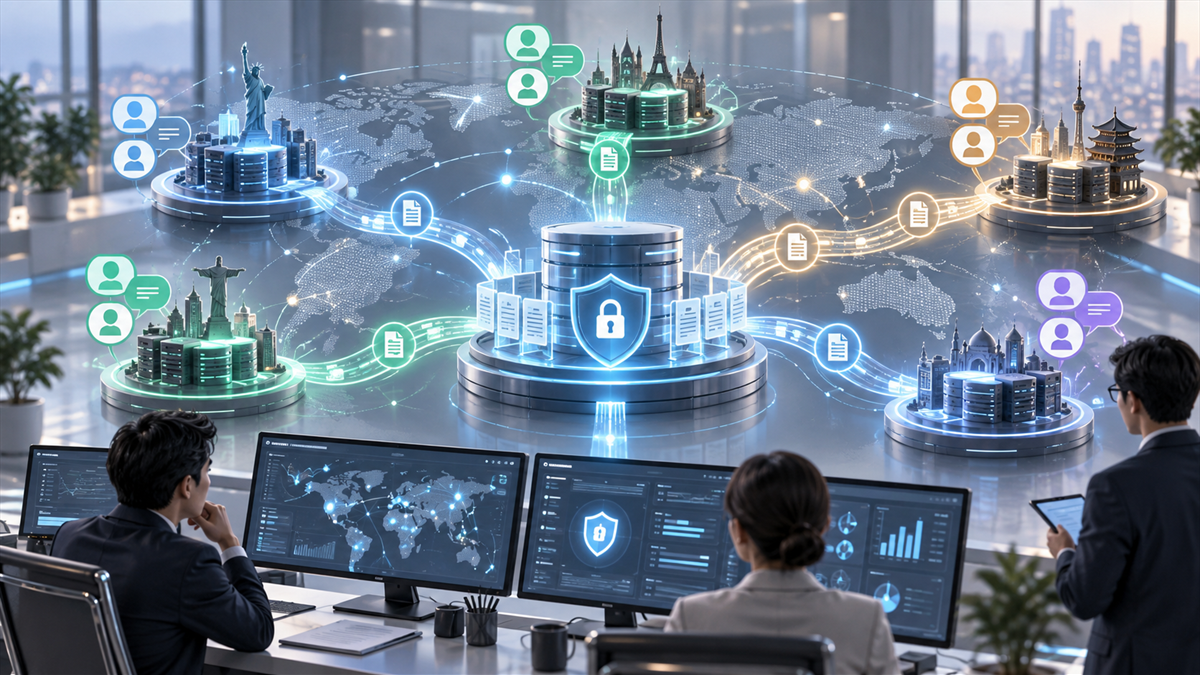
- ユーザー識別子、リクエスト言語、地域、モデル、プロンプトテンプレートIDを構造化して残す
- 個人情報や機密情報を含む入力は、原文保存と要約保存の可否を地域別に決める
- 越境移転が制限される地域では、ログの保管場所と処理場所を分けて設計する
- 監査担当者が読めない言語のログは、要約・タグの自動付与で検索性を担保する
- 保持期間と削除フローは、言語や地域単位ではなく法的根拠単位で決める
過剰にログを取り、後から削除する運用は監査上のリスクを増やします。データ最小化を先に決め、必要なデータを構造化して保存する設計が実務では扱いやすいです。
実装・運用で確認すべき項目
導入前に、次の項目を担当と一緒に埋めてから運用に入ります。
- 対象ユーザーの言語と地域を業務単位で棚卸ししたか
- プロンプトテンプレートの共通層と言語層を分離したか
- 言語別のゴールデンデータセットを、業務クリティカルな用途で用意したか
- 言語別の幻覚率と用語誤用率を、少なくとも月次で計測できるか
- 監査ログに言語、地域、モデル、テンプレートIDが構造化して残るか
- 地域別のデータ保持先とアクセス権が、法的根拠に基づいて決まっているか
運用開始後は、次の指標を継続的に見ます。
| 指標 |
何を測るか |
使い方 |
| 言語別1リクエストコスト |
言語ごとの月次費用の偏り |
高コスト言語のプロンプト最適化を優先する |
| 言語別幻覚率 |
言語ごとの誤情報発生率 |
評価データ拡充とテンプレート改善の優先順位に使う |
| 言語別ユーザー修正率 |
ユーザーが出力を書き換えた割合 |
業務での実用度の代理指標として使う |
| 地域別監査ログ検索時間 |
監査依頼への平均対応時間 |
ログ設計の改善余地を判断する |
| 言語別キャッシュ率 |
プロンプトキャッシュの命中率 |
共通層と言語層の分割方針を見直す |
リスクと限界、採用しないほうがよい条件
多言語運用は、対応言語を増やすほど運用コストが線形以上に増えます。次のリスクを事前に想定します。
- 主要LLMの言語性能差が業務ドメインでは残り、汎用ベンチマークだけで判断できない
- 機械翻訳経由の運用は、法務・医療・契約領域では誤読リスクが業務許容水準を超えることがある
- 地域規制の変更で監査要件が急に増え、後追いのログ拡張が難しくなる
- 現地拠点のレビュー体制がないまま横展開すると、品質責任の所在が曖昧になる
- 言語別の運用指標を作らないまま利用が広がると、経営から品質・コストが見えなくなる
次のような場合は、多言語対応を先送りするか対象を絞る判断が有効です。
- 業務クリティカルな出力で、対象言語のレビュー体制を用意できない
- 地域規制で必要になる監査ログ・データ保持要件を満たせない
- 対象言語での評価データを、社内・現地パートナーで用意できる目処が立たない
- 対象言語のユーザー規模が小さく、専用運用のコストが業務効果を超える
Blackfordの見解:業務データと運用責任に接続する
多言語運用の議論は、モデル選定や翻訳精度の話に寄りがちですが、Blackfordでは業務データと運用責任の設計に接続して考えることを重視しています。
- 業務データ側:社内ナレッジ・契約・製品情報を言語ごとにどう整備するか。RAGを含む社内データ活用は
/dataroidで相談できます
- クラウド構成:地域ごとのデータ保持、VPC、権限、監査ログの実装は
/dataroid-cloudと接続する論点になります
- 営業・顧客対応の多言語運用:日本語と英語の商談メール・応対では、
/salesroidのような業務特化の運用設計と切り分けます
- 全体相談:業務課題、対象言語、規制要件、運用責任者を含めた設計判断は
/contactから相談してください
自社サービスを解決策として先に置くのではなく、「業務」「データ」「クラウド」「運用責任」を先に整理し、その上で必要な運用設計と支援を組み立てる進め方を推奨します。
よくある質問
LLM多言語運用は日本語だけの企業でも必要ですか?
海外拠点や海外顧客対応がない場合、優先度は高くありません。ただし、社内利用でも英語文献の要約や英語問い合わせ対応が発生する業務では、日本語だけの評価では品質を保証できません。業務単位で対象言語を棚卸しし、必要な言語だけ運用を分けるほうが実務的です。
機械翻訳経由と直出力はどちらが良いですか?
用途によります。定型的な業務メール・FAQ回答では機械翻訳経由でも成立しますが、契約・医療・金融領域では直出力のほうが誤読リスクを抑えやすい傾向があります。用途別に少数の代表ケースで比較評価し、業務許容度に応じて方式を分けるのが妥当です。
言語ごとに別モデルを使うべきですか?
原則は同一モデル・同一運用を維持し、必要な業務用途だけ別モデルを検討します。モデルを分けると評価・監査・コストの管理が言語×モデルで増え、運用負荷が急増します。まずは同一モデルで言語別評価データを揃え、明確に品質差が出た場合だけモデル分岐を検討してください。
監査ログはどの言語で残すべきですか?
原文と、監査担当者が読める言語のタグや要約を併記する構成が扱いやすいです。原文を無理に翻訳して保存すると、翻訳誤差が監査結果に影響する可能性があります。原文+構造化タグ+必要に応じた要約の三点セットで、検索性と証跡性を両立させます。
まとめ
LLM多言語運用は、翻訳を差し込む後付けの作業ではなく、プロンプト・評価・監査を言語ごとに揃える運用設計の問題です。日本語で通用した運用をそのまま海外に横展開すると、品質・コスト・法務のいずれかで無理が出ます。
ただし、対応言語を増やすほど運用コストは線形以上に伸びます。業務単位で対象言語を棚卸しし、業務クリティカルな用途から段階的に整えるのが失敗しにくい進め方です。自社の言語構成と規制要件を整理し、必要な範囲に絞って設計するところから始めてください。
\多言語LLM運用の設計を相談できます/
Blackfordに相談する