この記事でわかること
- 「オープンソースLLM」と「オープンウェイトLLM」の違い
- Llama・Qwen・DeepSeek・Mistralのライセンス条件と商用利用可否
- API利用・セルフホスト・クラウド代理の3方式の使い分け
- EU居住者やユーザー数上限など、Llamaの実務制限
- 企業導入で確認すべきセキュリティ・データ主権の項目
結論サマリー:まずはApache 2.0モデルをAPI経由から
オープンソースLLMを企業で扱う場合、いきなり自社GPUでのセルフホストに進む必要はありません。まずはApache 2.0やMITのモデルをAPI経由で試し、規模と要件が固まってから運用形態を決めるのが現実的です。
| 用途 |
第一候補 |
理由 |
注意点 |
| 汎用チャット・要約、まず試したい |
Qwen3系 |
Apache 2.0で商用利用の制限が少ない |
中国系ベンダーのAPI利用時はデータ経路を確認 |
| 長文コンテキスト、大量要約 |
Llama 4 Scout |
長大なコンテキスト長を強みとする |
Community Licenseの制限条件を確認 |
| 高性能な汎用推論、コスト重視 |
DeepSeek系 |
MITライセンスで単価が低い |
提供元・データ経路の社内ポリシー確認 |
| EU拠点・欧州市場向け |
Mistral系 |
Apache 2.0でEU圏の提供体制がある |
用途に合うモデルサイズを選ぶ |
迷ったら、Apache 2.0またはMITのモデルを、まず公式APIまたは主要クラウドの代理提供で試すのが、ライセンス確認とGPU投資の両方を後回しにできる設計です。
※モデルの料金、提供範囲、機能、ライセンス条件は変更される場合があります。導入前に各モデルの公式情報で最新条件を確認してください。
オープンソースLLMの基本:オープンウェイトとの違い
オープンソースLLMは、モデルの重み(weights)を公開し、ダウンロード・実行・再配布・微調整を許可するLLMの総称です。ただし、公開範囲や条件はモデルによって異なります。
主要用語を先に押さえます。
| 用語 |
意味 |
| オープンウェイト |
モデルの重みだけ公開する形態。学習データやコードは非公開 |
| オープンソース |
重みに加え、学習コードやデータの一部を公開する形態 |
| ライセンス |
商用利用・再配布・派生モデル作成の条件を定めた文書 |
| Apache 2.0 |
商用利用可、再配布可、特許条項ありの寛容なライセンス |
| MIT |
商用利用可、再配布可、条件が最小限の寛容なライセンス |
| Community License |
提供元が独自条件を付けたライセンス |
「オープンソース」を厳密に定義するOSI(Open Source Initiative)の基準では、多くのLLMは正確にはオープンウェイトモデルに分類されます。
ただし、日本語での実務会話では両者を合わせて「オープンソースLLM」と呼ぶことが多く、本記事もこの慣習に従います。
重要なのは名称よりも、実際のライセンス条項でどこまで商用利用が許されているかです。
主要オープンソースLLMの比較
主要オープンソースLLMは、開発元・提供地域・強みで分かれています。
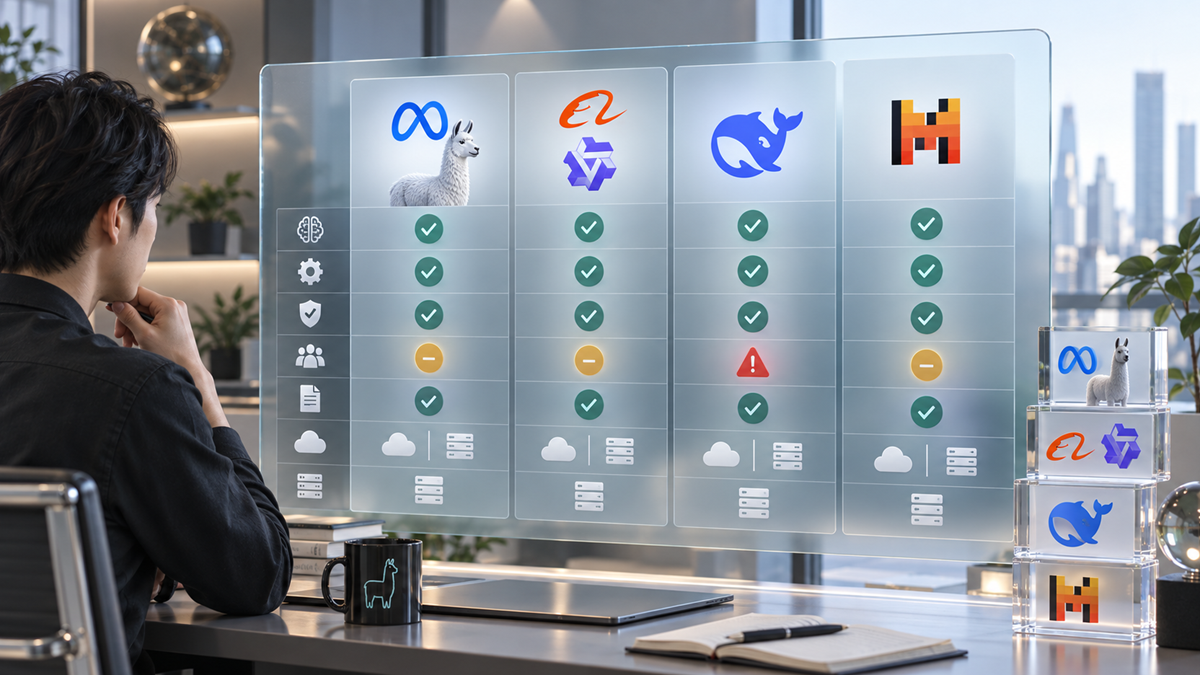
まず一般読者向けの概要比較です。
| モデル |
一言でいうと |
得意な用途 |
注意点 |
| Llama系(Meta) |
米国発の汎用モデル、エコシステムが厚い |
汎用チャット、長文コンテキスト |
Community LicenseでEU制限・ユーザー数上限あり |
| Qwen系(Alibaba) |
中国発の多言語モデル、Apache 2.0で自由 |
多言語対応、コーディング、汎用推論 |
API利用時はデータ経路の確認が必要 |
| DeepSeek系 |
中国発の高性能モデル、MITで低単価 |
難関推論、コーディング、コスト重視 |
提供元・API経路のガバナンス確認 |
| Mistral系(フランス) |
欧州発、Apache 2.0で商用利用に強い |
欧州市場、多言語、モデルサイズ選択肢 |
大型モデルは自社GPU要件が高い |
各モデルの位置づけを、選定時に必要な4項目で整理します。
Llama系
- 一言でいうと:Metaが提供する汎用オープンウェイトLLM
- 得意なこと:汎用チャット、長文要約、開発者コミュニティの厚さ
- 注意すべきこと:Community LicenseでEU居住者や大規模事業者に制限
- 向く企業:非EU拠点で、開発ノウハウを社内蓄積したい企業
Qwen系
- 一言でいうと:AlibabaのオープンウェイトLLM、Apache 2.0中心
- 得意なこと:多言語(日本語を含む)、コーディング、汎用推論
- 注意すべきこと:中国系APIを直接使う場合はデータ経路と規制の確認
- 向く企業:多言語対応が必要で、ライセンス制限を避けたい企業
DeepSeek系
- 一言でいうと:中国発、MITライセンスで高性能を狙う新興系
- 得意なこと:難関推論、コーディング、単価の低さ
- 注意すべきこと:提供元・データ主権に関する社内ポリシー確認
- 向く企業:コスト最適化を軸に、社内で運用体制を組める企業
Mistral系
- 一言でいうと:フランス発の欧州系オープンモデル、Apache 2.0
- 得意なこと:欧州言語、モデルサイズの選択肢、EU圏での提供体制
- 注意すべきこと:大型モデルはセルフホストで自社GPU要件が上がる
- 向く企業:欧州事業がある、または欧州データ規制を意識する企業
ライセンスと商用利用条件の比較
ライセンスは選定の第一制約になります。商用利用の可否だけでなく、地域制限や派生モデル作成条件も確認します。
主要ライセンスの違いを整理します。
| ライセンス |
商用利用 |
主な採用モデル |
注意点 |
| Apache 2.0 |
制限なく可 |
Qwen3系、Mistral系、Gemma系 |
特許条項あり、ライセンス明示義務 |
| MIT |
制限なく可 |
DeepSeek系、Phi系 |
条件が最小限、免責条項の明示のみ |
| Llama Community License |
条件付きで可 |
Llama 4 Scout/Maverick |
ユーザー数上限、EU制限、派生モデル命名規則 |
| 独自の条件付きライセンス |
個別確認 |
一部の大型MoEモデル |
商用利用の上限や用途制限が個別に設定される |
Llama Community Licenseで特に確認が必要なのは次の3点です。
- ユーザー数の上限:月間アクティブユーザー数が7億人を超える事業者は、Metaから別途商用ライセンスを取得する必要がある
- EU域内での利用制限:EU AI ActとGDPRを踏まえ、EU域内の個人・組織による公式ダウンロードや利用に制約がかかる場合がある
- 派生モデルの命名規則:Llamaを基に作った派生モデルは、モデル名の先頭に「Llama」を含める必要があり、成果物のマーケティングでは「Built with Llama」の明記が求められる
中小・中堅企業では、ユーザー数上限に達することは通常ありません。ただし、EU拠点や欧州市場への展開が視野にある場合は、Llama系よりApache 2.0/MIT系を優先する方が安全です。
導入方式の選び方:API・セルフホスト・クラウド代理
オープンソースLLMを実務で使う方法は、大きく3つに分かれます。用途と規模で選び分けます。
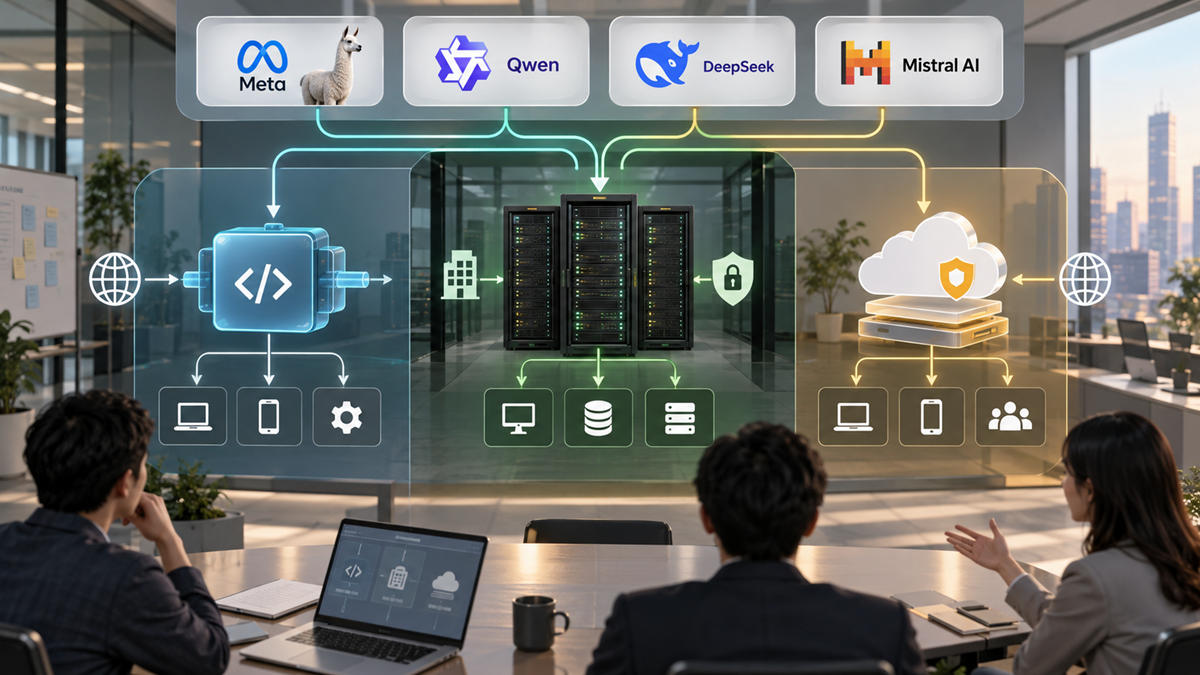
| 導入方式 |
概要 |
向く用途 |
注意点 |
| 公式API |
モデル提供元のAPIをそのまま使う |
まず試したい、規模が小さい |
データ経路と保持条件を確認 |
| クラウド代理提供 |
AWS Bedrock・Azure・Google Cloudなどが提供する形で使う |
既存クラウド契約と統合したい |
提供モデルの世代と単価を確認 |
| セルフホスト |
自社GPUまたはクラウドGPUで直接動かす |
機密性・データ主権が最重要 |
GPU投資と運用体制が必要 |
セルフホストの初期コストは、モデルサイズと量子化条件で変わります。
- 7B〜13B規模のモデル:単一のGPUカードで動作する場合が多く、検証環境から始めやすい
- 30B〜70B規模のモデル:4bit量子化により1台のハイエンドGPUで動作する場合があるが、応答速度と同時接続数は業務要件を満たすか要確認
- 数百B超級のMoEモデル:複数GPUノード構成が前提で、初期投資と運用ノウハウの両方が必要
セルフホストの損益分岐は、公式APIとの月次コスト比較で判断します。APIの月次利用料が数百万円規模を超えるまでは、セルフホストの合理性は薄いのが一般的な目安です。
企業導入で注意すべき点
オープンソースLLMを企業で使う場合、モデル選定より先に確認すべき項目があります。
ライセンス条件
- 商用利用可否と再配布条件を条項レベルで確認する
- 派生モデルの命名規則・帰属表示の義務を確認する
- ユーザー数上限や地域制限を業務範囲と照合する
データ主権とセキュリティ
- 入力データの学習利用可否を確認する
- APIプロバイダのデータ保持期間・削除条件を確認する
- 社外秘資料・個人情報の入力可否をポリシー化する
運用体制
- モデル更新・廃止時のロールバック手順を用意する
- 公式APIとセルフホストの併用可否を設計する
- 監査ログ・アクセス制御の仕組みを事前に整える
コスト管理
- API単価とセルフホストGPUコストを月次で比較する
- 予期しない大量利用に備えた上限設定を入れる
- 量子化・キャッシュ活用による削減余地を確認する
社内知識と接続
- 社内文書検索・RAGとの接続方針を先に決める
- 業務ワークフローへの組み込み範囲を明確化する
- 導入後の効果測定指標を先に定義する
Blackfordの見解:ライセンスと業務設計を分けて考える
オープンソースLLMは、「安いから使う」だけでは業務定着しません。Blackfordはお客様のAI導入相談で、次の順序を推奨しています。
- 業務課題と扱うデータの機密度を先に整理する
- 機密度と規模から、公式API・クラウド代理・セルフホストの方式を選ぶ
- 方式に合うライセンスのモデルを絞り込む
- 単価・成果・運用負荷を月次で計測し、割当を見直す
社内文書検索やナレッジ活用を絡める場合は、/dataroidや/dataroid-cloud側でモデルを差し替えられる設計にすると、オープンソースLLMとクローズドLLMを用途で使い分けられます。営業・顧客対応の自動化は/salesroid側で用途別モデルを設定できます。
モデル選定は業務設計・データ主権・運用体制の3点と一体で判断するのが、ライセンス違反リスクと運用破綻を同時に避ける近道です。
\オープンソースLLM導入の判断を相談できます/
Blackfordに相談する
よくある質問
オープンソースLLMは商用利用できますか?
多くの主要モデルは商用利用可能です。ただし、条件はライセンスごとに異なります。Apache 2.0(Qwen3、Mistral系)とMIT(DeepSeek系、Phi系)は制限なく商用利用できます。Llama系はCommunity Licenseで、ユーザー数上限やEU制限などの条件がかかるため、業務範囲と照合して確認してください。
中小企業でもオープンソースLLMを自社運用できますか?
小規模モデルであれば運用は可能です。7B〜13B規模のモデルは単一のGPUカードで動く場合が多く、社内検証から始めやすい水準です。ただし、業務要件(応答速度・同時接続数・稼働時間)を満たすには、規模を上げる必要があり、その時点でクラウドGPUや専用ハードの投資判断が必要になります。まずは公式APIまたはクラウド代理提供で試すのが現実的です。
Llama系とQwen系はどちらを選ぶべきですか?
用途と地域で選び分けます。Llama系は開発者コミュニティが厚く、汎用チャット・長文コンテキストに強い一方、Community Licenseの条件確認が必要です。Qwen系はApache 2.0で商用利用の制限が少なく、多言語対応が強みです。EU拠点や欧州展開が視野にある場合はApache 2.0系を優先すると条件確認の手間が減ります。
セルフホストとAPI利用のどちらが安いですか?
利用規模で分岐します。小〜中規模の利用ではAPIが安く、規模が大きくなるとセルフホストの単価優位が出ます。目安として、公式APIの月次利用料が数百万円規模を超えてくると、セルフホスト検討の合理性が上がります。ただし、GPU投資・電力・運用工数を含めた総保有コストで判断してください。
社内の機密情報をオープンソースLLMに入力してもよいですか?
方式によって扱いが変わります。公式API利用時は、提供元のデータ保持条件と学習利用可否を必ず確認してください。クラウド代理提供(AWS Bedrock等)では、契約するクラウド側のデータ扱いが優先されます。セルフホストの場合は自社ネットワーク内で完結するため、機密情報の扱いは自社ポリシーに従います。方式選択の段階で、機密度に応じた運用ルールを先に決めてください。
まとめ
オープンソースLLMは、Apache 2.0・MIT・Community Licenseなどライセンス条件によって商用利用の自由度が大きく変わります。Llama・Qwen・DeepSeek・Mistralはそれぞれ強みと制約が異なり、用途と地域で選び分けるのが現実的です。
導入は「セルフホストありき」ではなく、公式API→クラウド代理→セルフホストの順に規模と要件が固まってから運用形態を選ぶのが安全です。ライセンス確認、データ主権、運用体制の3点を一体で設計してください。
自社での活用可否に迷う場合は、業務課題と扱うデータの機密度を整理したうえで、モデル選定と運用体制の判断を相談してください。
\2026年度版: オープンソースLLM選定ガイド/
Blackfordに相談する