
MCPサーバー上で動くLLMエージェントは、社内システムに実際の変更を加える運用フェーズへ入りつつあります。一方で、最終回答が正しければ合格とする既存のベンチマークは、そのようなライブ環境の評価には十分ではありません。
2026年7月10日にarXivで公開されたDynamicMCPBench論文(Jerzy Kamińskiほか、arXiv:2607.20531)は、この課題を正面から扱います。提案は「エージェントが引き起こした副作用を再現できたか」で採点する枠組みです。
MCPサーバー上で動くLLMエージェントは、社内システムに実際の変更を加える運用フェーズへ入りつつあります。一方で、最終回答が正しければ合格とする既存のベンチマークは、そのようなライブ環境の評価には十分ではありません。
2026年7月10日にarXivで公開されたDynamicMCPBench論文(Jerzy Kamińskiほか、arXiv:2607.20531)は、この課題を正面から扱います。提案は「エージェントが引き起こした副作用を再現できたか」で採点する枠組みです。
1. 副作用の再現で採点する新設計
DynamicMCPBench論文(arXiv:2607.20531、2026年7月)は、最終回答ではなく効果チェックポイントの再現率でスコアを算出します。
2. ライブ環境での大規模実験
24モデル、121のMCPサーバー、15カテゴリ×50タスクの合計750タスクを、Pass@3(3回連続成功)で評価しました。
3. 長連鎖では精度が急落する
最良モデルでも解決率は約50%、全モデルが失敗したタスクは31%。連鎖の長いタスクでは39%から13%へ精度が落ちます。
既存のツール利用ベンチマークは、正解ツール列と最終回答の一致で採点する設計が多いです。
しかし実際のMCPサーバーは状態を持ち、同じ目的でも正しい経路が複数存在します。固定正解列を要求すると、代替経路まで不合格になります。
さらに、最終回答が偶然合っても途中で意図しない副作用があれば実運用では失敗です。既存ベンチマークは、その差を見分けられません。
論文の直感はシンプルです。答えの一致ではなく「本来変えるべき状態を、本来変えるべき方向に変えたか」で評価する発想です。
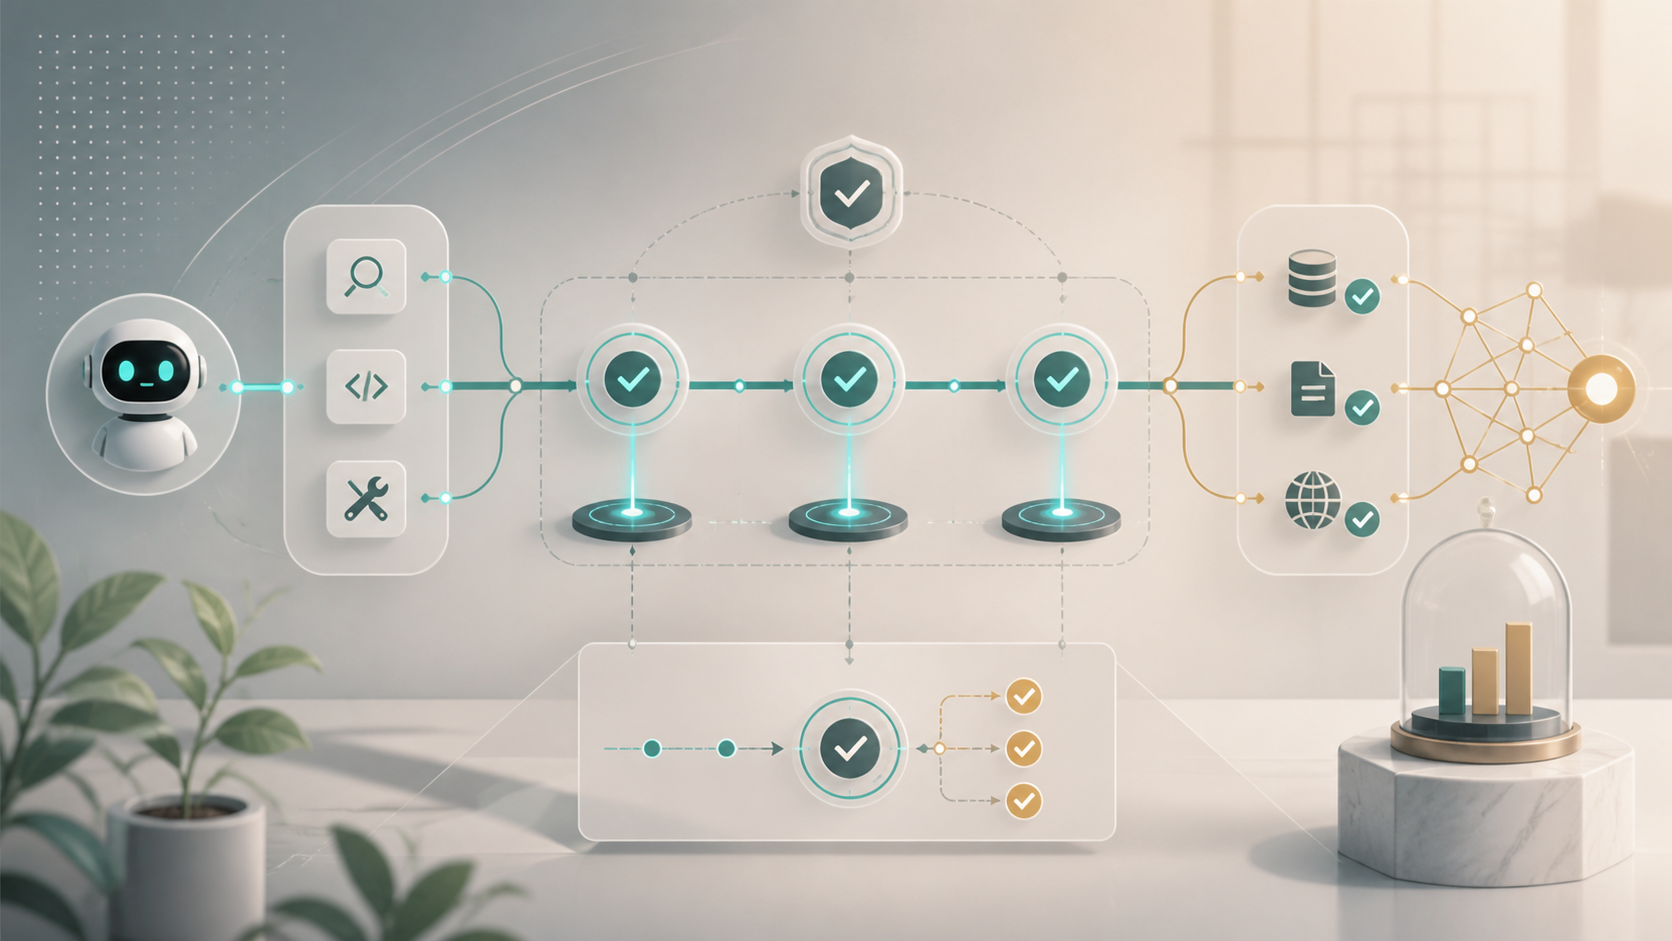
技術的には次の3段階で構築されています。
これにより、経路が異なっても効果が同じなら合格、経路が正しくても副作用が抜けていれば不合格になります。運用視点の採点が組み込まれた点が、既存ベンチマークとの決定的な差分です。
固定データセットではなく、ライブサーバーへ再利用できるフレームワークとして実装されている点も特徴です。企業が自社MCPサーバーへ持ち込み、社内タスクで評価し直せます。
論文は24モデル・121サーバー・750タスクをPass@3で評価しました。3回とも合格した場合のみ「解けた」とカウントする厳しい設計です。
主要な結果は次のとおりです。
| 比較軸 | 結果 | 実務上の読み方 |
|---|---|---|
| 最良モデルの解決率 | 約50% | 単体エージェントでの一気通貫運用はまだ難しい |
| 全モデルが失敗したタスク | 31% | 現行フロンティアLLMでも構造的に苦手な領域が残る |
| 短い連鎖の精度 | 39% | 数ステップでも半分未満、事前設計が必要 |
| 長い連鎖の精度 | 13% | 長時間タスクは分割と人手確認が現実的 |
| 人手検証との一致 | 0.76(偶然補正済み) | 効果ベース採点は主観評価より安定していると読める |
論文はモデル別のランキングそのものより、カテゴリ別・連鎖長別に精度構造が変わる点を強調しています。同じモデルでも扱うMCPサーバー群や業務種類で得手不得手が大きく変わる、というのが読み方です。
論文自身も、長く多段のエージェントタスクは現行モデルの弱点だと明示しています。この点を「モデル選定で解決できる」と読むのは早計です。
適用時に気を付けたい論点は次のとおりです。
論文の数値をそのまま社内モデル選定の根拠にせず、評価設計の考え方として取り込むのが安全です。
エージェント運用を検討する中堅・中小企業にとって、この論文の実務価値は「評価軸の再設計」にあります。
導入判断で使えるチェックリストは次のとおりです。
社内で扱うタスクごとに、求める効果と検査方法を先に決めることが、モデル比較より先に必要な準備になります。
DynamicMCPBenchは、フロンティアLLMの序列付けよりも、評価枠組みの提示として重要です。中堅・中小企業の現場では、Blackfordの視点で次の3点として解釈します。
エージェントの評価は、モデル選定より先に「効果の定義」から始めるのが、この論文が示す実務上の指針です。
社内エージェントの評価設計や、MCPサーバーを含むAI開発・実装の伴走は、Blackford Technologiesで支援しています。
Q. MCPとは何ですか?
A. Model Context Protocolの略で、LLMが外部ツールやデータソースへ統一的な方式で接続するためのプロトコルです。Anthropicが提唱し、2025年以降エコシステムが拡大しています。DynamicMCPBenchは、このMCPサーバー群を評価対象としています。
Q. 効果ベース採点は自社ベンチマークにも使えますか?
A. 論文はフレームワークとして提供され、自社MCPサーバーへの持ち込みを想定しています。ただし効果チェックポイントの抽出には成功軌跡が必要なため、事前に模範実行を1本用意する運用が発生します。
Q. 現状で「安全に本番運用できるエージェント」を選べる基準はありますか?
A. 現時点で単一の基準を断定はできません。本論文の結果は、最良モデルでも半分程度、長連鎖では13%という水準です。本番運用は業務領域を絞り、Pass@k評価と人間の確認を組み合わせるのが現実的です。
Q. Pass@3とは何ですか?
A. 同じタスクを独立に3回実行し、3回とも合格したときだけ解けたと数える指標です。1回だけの成功では「たまたま」通ってしまう可能性を排除し、本番のばらつきを可視化できます。
DynamicMCPBench論文は、LLMエージェントの評価を「回答一致」から「効果の再現」へ切り替える枠組みを示しました。ライブMCPサーバー上での24モデル・750タスクの実験からは、最良モデルでも約50%、長連鎖で13%という現実的な精度水準が見えます。
これは「AIエージェントはまだ全自動運用に向かない」というよりも、「評価軸を作り直せば運用可否を測れる」という前向きなメッセージです。自社エージェントの評価設計や、MCPを前提としたデータ基盤の準備を進めるなら、下記からご相談ください。




