
社内データでLLMを選好学習させると、アノテーターごとに評価が揺れる問題に必ずぶつかります。RGPOは「揺れたラベルをそのまま学ばせないこと」を狙って設計された、DPOの改良版です。
本記事では、2026年7月にarXivで公開された論文『Reliability-Aware LLM Alignment from Inconsistent Human Feedback』を取り上げます。ICML 2026採択の選好最適化手法で、中身・公開ベンチマーク結果・社内RLHFへの示唆を整理します。
社内データでLLMを選好学習させると、アノテーターごとに評価が揺れる問題に必ずぶつかります。RGPOは「揺れたラベルをそのまま学ばせないこと」を狙って設計された、DPOの改良版です。
本記事では、2026年7月にarXivで公開された論文『Reliability-Aware LLM Alignment from Inconsistent Human Feedback』を取り上げます。ICML 2026採択の選好最適化手法で、中身・公開ベンチマーク結果・社内RLHFへの示唆を整理します。
要点1: アノテーターの合意度を無視したDPO学習は、勝率と説明品質を過剰に下げる恐れがあります。RGPOは意見が割れた対を弱く学ばせる設計で、Llama-3-8B-InstructのAlpacaEval 2 LC勝率を35.55%から38.30%へ引き上げました。
要点2: 中身は2つの新規要素で構成されています。信頼度を推定する「ILRE」と、その信頼度で損失を調整する「RACO」を組み合わせ、既存のDPOパイプラインに差し込みます。
要点3: 著者はJingyi Huang氏・Ruohan Zong氏らで、2026年7月7日にarXiv公開、ICML 2026に採択されました(arXiv:2607.20515)。学習・評価コードはGitHubで公開されており、TRLベースで動かせます。
DPO(Direct Preference Optimization)は、「Aの応答がBより好き」というペアデータで直接LLMを最適化する手法です。強化学習を挟まず報酬モデルも作らない軽量さで、社内RLHFの主流になっています。
一方で、DPOは全ペアを同じ重みで扱います。実際の人間ラベルは、対象タスク、判定者の好み、指示解釈のズレによって食い違いが出ます。
論文が使ったMultiPrefは227名から10,461ペア、HelpSteer2は6名から11,824ペアの多重評価データで、意見が割れる比率は無視できません。既存の対策である「多数決で1票にまとめる」「confidenceでフィルタする」では、割れたペアと合意ペアを同じ強さで学習してしまう構造が残ります。
RGPOはDPO本体を書き換えず、前段の「ラベルの読み替え」と後段の「損失の重み付け」を差し替えます。
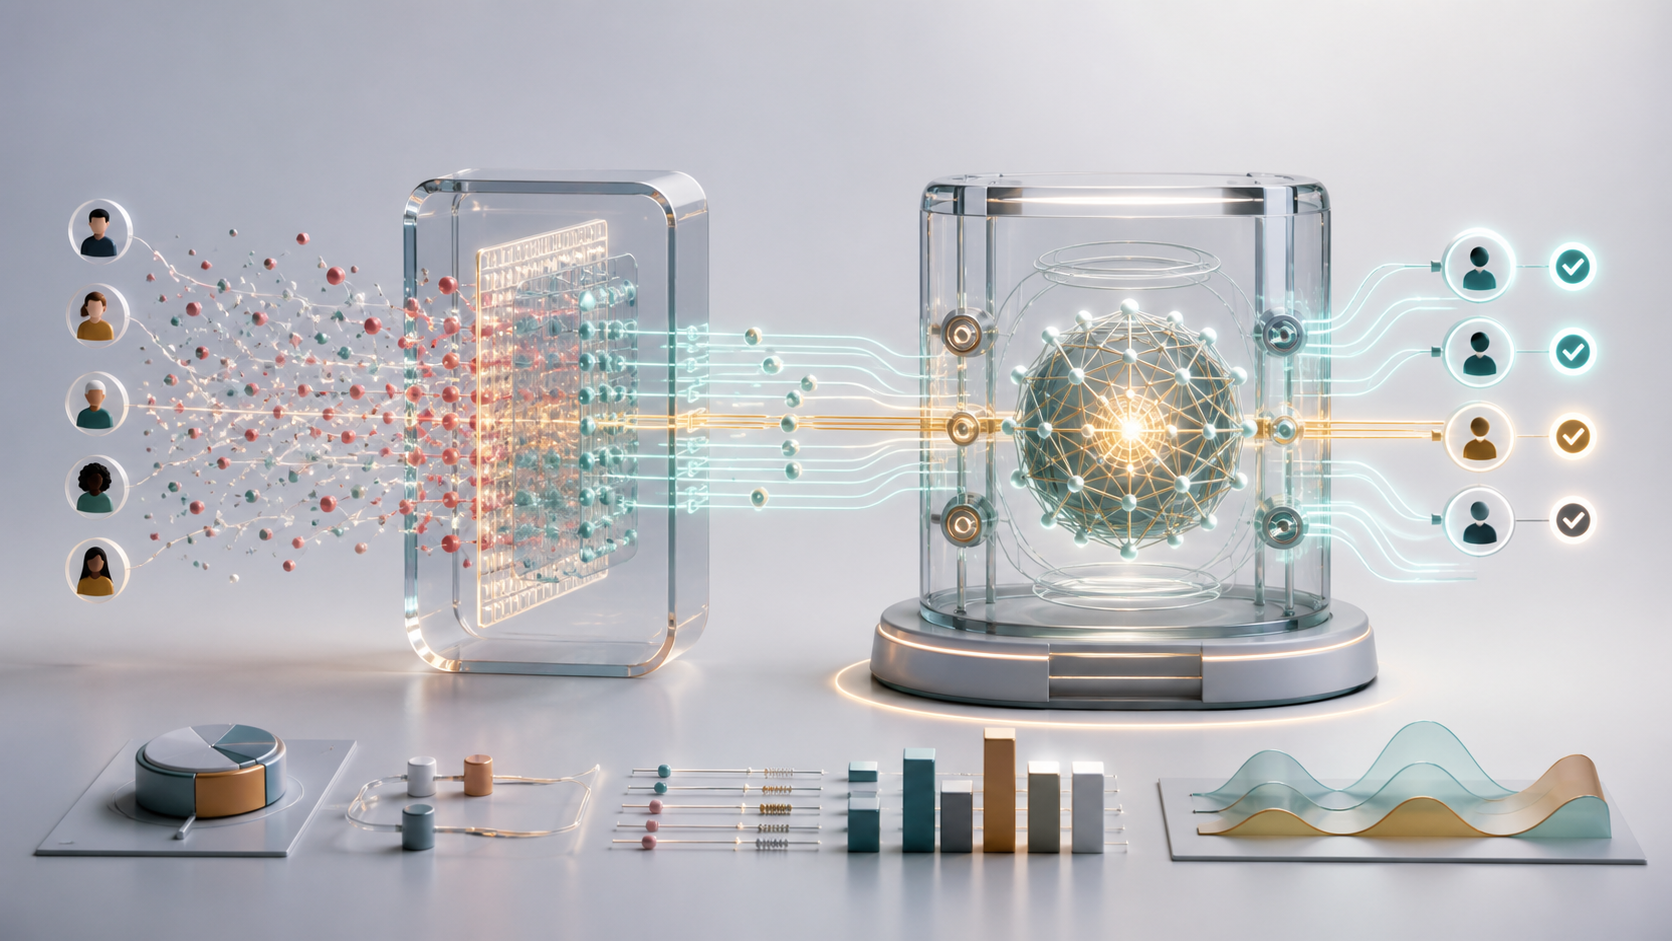
ILRE(Inconsistency-aware Label Reliability Estimation)は、複数アノテーターのラベルを最尤推定で処理し、各人の信頼度と本来の正解ラベルを同時に推定します。合意度が低いペアは自動的にタイ(引き分け)として扱えます。
論文の分析ではMultiPrefで、単純アンサンブルだと12.27%だったタイ検出率が29.03%まで上がっています。「割れているのに片方に寄せて学ばせる」誤学習を、事前段階で止められるのがILREの直感的な狙いです。
RACO(Reliability-Aware Consistency Optimization)は、推定した信頼度を損失関数に組み込みます。合意度が高いペアほど強く学び、低いペアはゆるく学ぶことで、ノイズ由来の過学習を抑えます。
社内RLHFに置き換えると、次のような変換に近いです。
論文はLlama-3-8B-InstructとQwen2.5-7B-Instructの2モデル、MultiPrefとHelpSteer2の2データセットで、DPO・IPO・SimPO・KTOなどと比較しています。
代表的な数値は次のとおりです(Llama-3-8B-Instruct×MultiPref、AlpacaEval 2およびArena-Hard)。
| 比較軸 | DPO単体 | RGPO併用 | 実務上の読み方 |
|---|---|---|---|
| AlpacaEval 2 LC勝率 | 35.55% | 38.30% | 応答長補正込みで説明品質が伸びる |
| AlpacaEval 2 素勝率 | 39.51% | 40.74% | 長さ補正なしでも改善が確認 |
| Arena-Hard勝率 | 43.70% | 46.60% | 難問系タスクの伸び幅が大きい |
アブレーションでは、ILREのみ・RACOのみでも改善は出ますが、両方を組み合わせた時に最大効果が出る構造です。ILREを外すとAlpacaEval 2とArena-Hardの両方で大きく落ちる点から、ラベル信頼度の推定が伸びの中核と読めます。
数値の絶対水準ではなく「同一データ・同一base modelで、より賢く学べた」差分として読む必要があります。学習データ自体の質を上げる代替にはならない点は、実務展開の期待値調整として押さえる項目です。
論文の適用範囲は、「多重アノテーション付きの選好データ」を持っている前提です。1人だけがラベル付けした社内データにそのまま持ち込むと、ILREが機能しません。
未検証または注意が必要な点は次のとおりです。
社内で選好学習を回している、あるいは検討中の中小企業には、次のチェックリストとして使えます。
導入前チェックリスト:
上記が満たせない段階では、アノテーション設計を見直すほうが優先度が高いケースが多いです。RGPOは「合意度をきちんと測れる体制」があってはじめて効きます。
RGPOの本質は、アノテーターの揺らぎを学習パイプラインの中で1級市民として扱う設計にあります。社内RLHFの現場では、ラベル揺らぎはインシデントではなく前提条件です。
社内で選好学習を検討する場合、モデル選定や損失関数の選び方より先に、次の3層を整えることをおすすめします。
この土台の上で、RGPOのような損失側の工夫が効いてきます。Blackfordが提供するDataRoidは、社内ナレッジや会話ログから評価用データセットを整える工程で活用できます。
Q. RGPOは既存のDPO学習パイプラインにどれくらいの改修で入りますか。
A. 論文と公開実装はTRLベースで、DPOの前段にILREを、損失側にRACOを差し込む構成です。多重アノテーション付きデータが用意できていれば、既存学習コードへの改修は限定的です。
Q. 1人のアノテーターしかいない社内データでも効果はありますか。
A. 論文が扱う効果は多重ラベル前提です。単一ラベルデータではILREの信頼度推定が機能せず、実質DPOと同じ挙動になります。まずは複数人ラベル体制の整備を優先してください。
Q. どのベースモデルで検証されていますか。
A. 論文の主要実験はMeta-Llama-3-8B-InstructとQwen2.5-7B-Instructです。より大規模なモデルや、日本語特化モデルでの再現性は未検証です。
Q. AlpacaEval 2やArena-Hardの数値は、実業務のKPIにそのまま対応しますか。
A. 対応しません。両ベンチマークは英語一般タスクの応答品質を測るもので、日本語業務ドメイン(FAQ、営業提案、社内ナレッジ検索など)は別途、社内評価データで測る必要があります。
RGPOは、ノイズ入り人間フィードバックを前提に、DPOの学習パイプラインをアノテーター信頼度で補強する手法です。Llama-3-8Bと公開評価では、AlpacaEval 2 LC勝率で+2.75ポイント、Arena-Hardで+2.90ポイントの改善が報告されています。
効果を引き出すには「多重アノテーション体制」と「一致率の把握」が前提です。社内RLHF導入で迷う場合は、モデル選定より先に、評価軸とアノテーション運用の設計を整えるところから始めることをおすすめします。




