
LLMアプリは、リリース直後の評価が高くても、運用半年で品質が静かに劣化しやすい仕組みです。原因の多くは、ユーザーの声を集める仕組みが「サムズアップ/ダウン」だけで止まり、改善担当者へ届かないことにあります。
この記事では、LLMアプリ本番運用のフィードバックループ設計を、シグナル収集、評価データ化、改善反映、品質モニタリングの4段階で整理します。読み終えると、自社のLLM運用で「最初に整える収集経路」と「ループを止めない運用責任者の置き方」を判断できます。
LLMアプリは、リリース直後の評価が高くても、運用半年で品質が静かに劣化しやすい仕組みです。原因の多くは、ユーザーの声を集める仕組みが「サムズアップ/ダウン」だけで止まり、改善担当者へ届かないことにあります。
この記事では、LLMアプリ本番運用のフィードバックループ設計を、シグナル収集、評価データ化、改善反映、品質モニタリングの4段階で整理します。読み終えると、自社のLLM運用で「最初に整える収集経路」と「ループを止めない運用責任者の置き方」を判断できます。
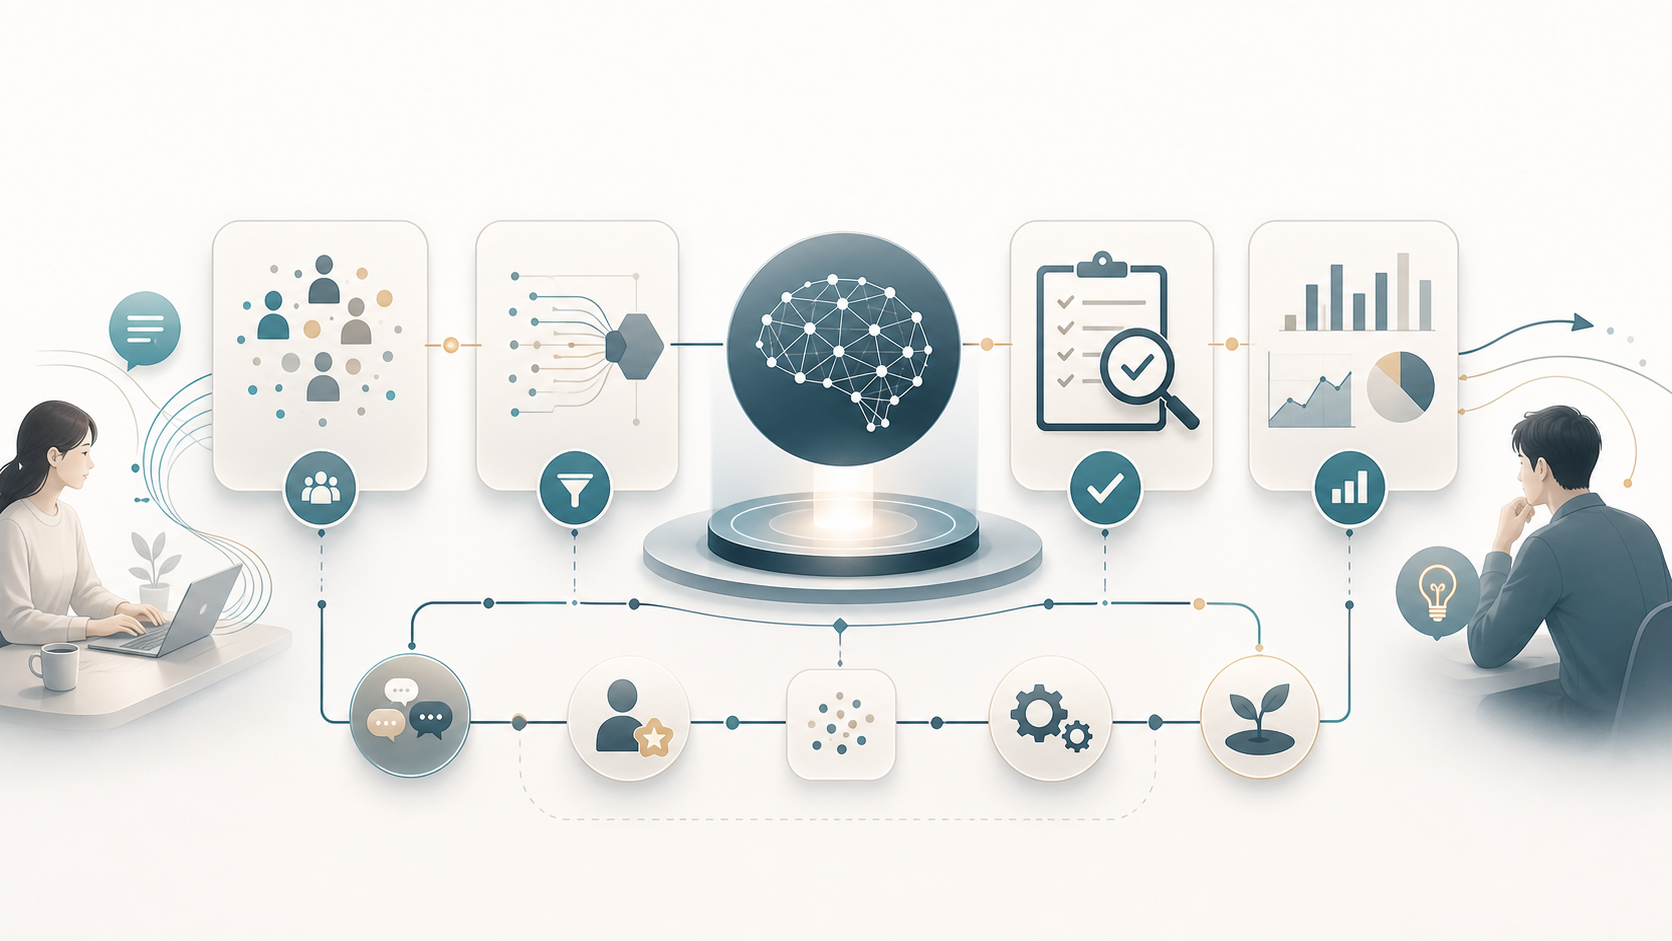
LLMアプリは、モデル単体を強化するだけでは品質を維持できません。ユーザーシグナルを評価データに変え、改善に反映し、再びシグナルで検証する4段階のループを運用に組み込みます。
| 段階 | 最初に見る指標 | 確認すること | 次の行動 |
|---|---|---|---|
| シグナル収集 | 高評価率、低評価コメント数、無回答率 | 評価ボタンと暗黙シグナルを両方取れているか | 収集経路と保存先、PII方針を決める |
| 評価データ化 | ゴールデン件数、難しい例の比率 | 本番例を正解付きデータに変換できているか | レビュー担当者と昇格基準を定める |
| 改善反映 | プロンプト変更回数、A/B勝率 | 何をどこに反映したか追跡できているか | 変更ログとロールバック手順を整える |
| モニタリング | 回帰率、コスト、遅延 | 改善後に別の品質が落ちていないか | 監視ダッシュボードと閾値を決める |
※LLM関連サービスの料金、データ保持条件、提供機能は変更される場合があります。導入前に公式情報で最新条件を確認してください。
LLMフィードバックループは、本番ユーザーの反応をデータ化し、評価と改善に再投入する運用サイクルを指します。モデル学習だけの話ではなく、プロンプト、RAG、ツール定義、UIまで含めた継続改善の入口として設計します。
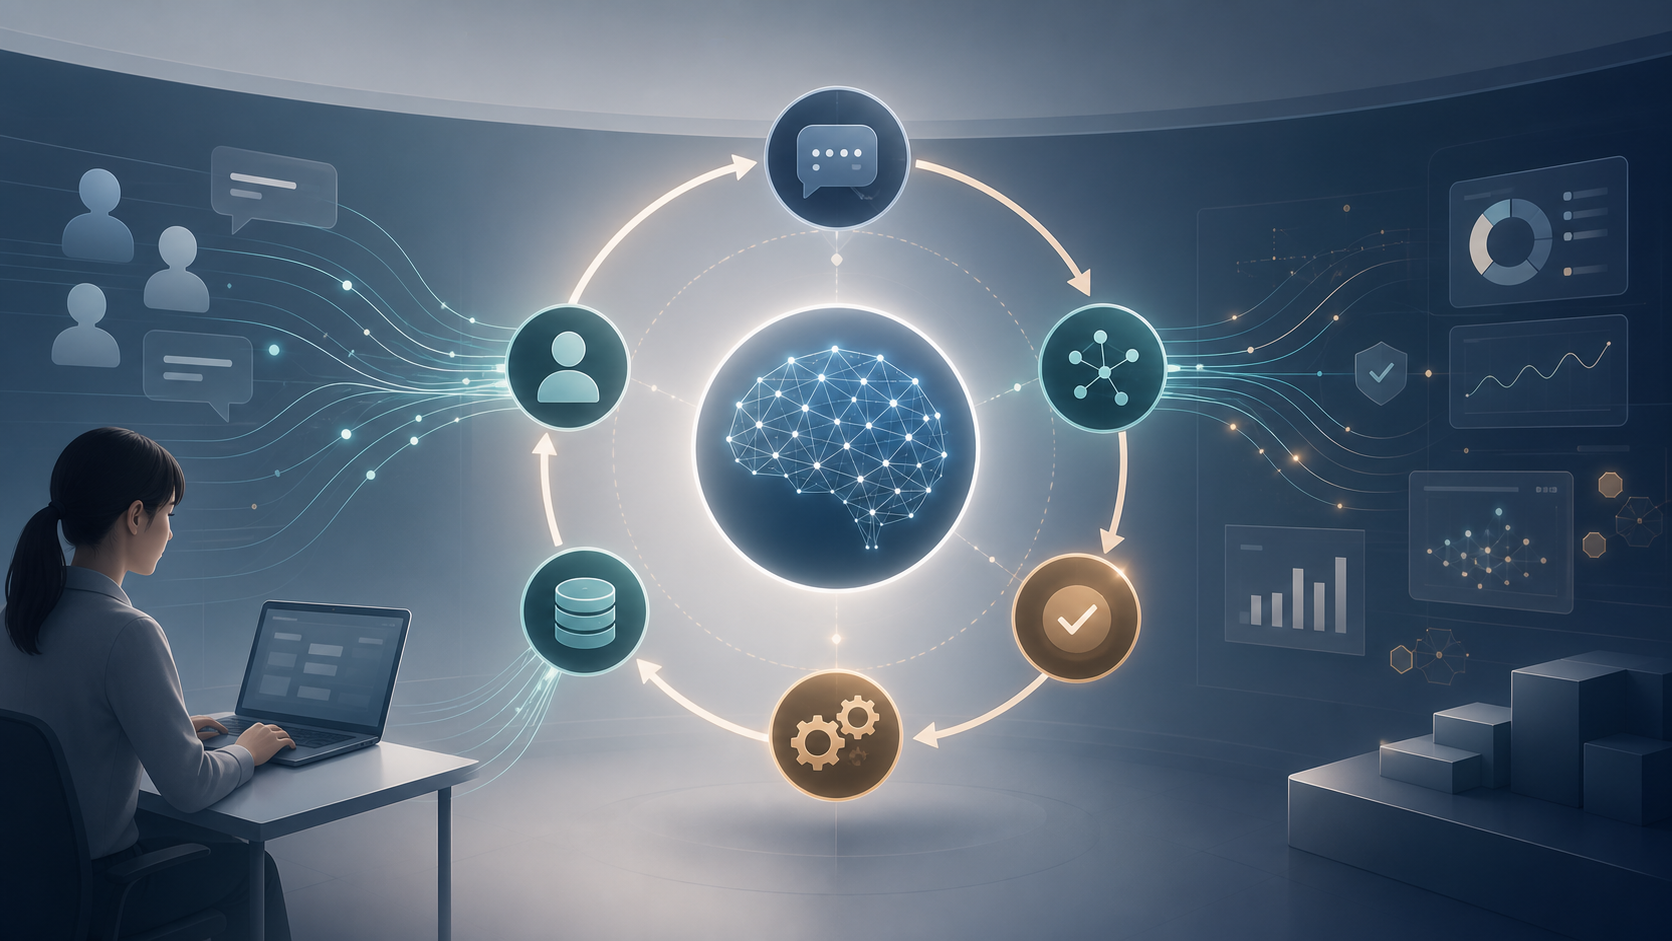
| 用語 | 意味 |
|---|---|
| 明示シグナル | サムズアップ/ダウン、星評価、コメントなどユーザーが意図して送る評価 |
| 暗黙シグナル | コピー、再質問、放棄、滞在時間などユーザーの行動から推定する評価 |
| ゴールデンデータセット | 正解付きの評価用データ。オフライン評価で使う |
| 回帰評価 | 改善後に既存品質が落ちていないかを既存データで検証すること |
| LLM-as-a-judge | 別のLLMに回答品質を採点させる方式 |
ループの粒度は3層に分けて考えます。早い層は「プロンプト・分岐ロジック」、中間は「RAGの検索方式やチャンク」、遅い層は「モデルやファインチューニング」です。
早い層から順に回し、コストの高い層は根拠が積まれてから動かします。
2026年のLLM運用は、PoCから定着フェーズへ移る段階に入りました。一方で、現場では次の問題が同時に起きやすくなっています。
フィードバックループが回り始めると、品質改善が直感の修正ではなく、評価データに基づく判断になります。これがLLMOpsの中で改善ループ設計を独立に扱う理由です。
最初に揃えるのは、ユーザー反応の取り方です。明示シグナルだけに頼ると押下率が低く、改善判断に使えないため、暗黙シグナルを併用して補完させます。
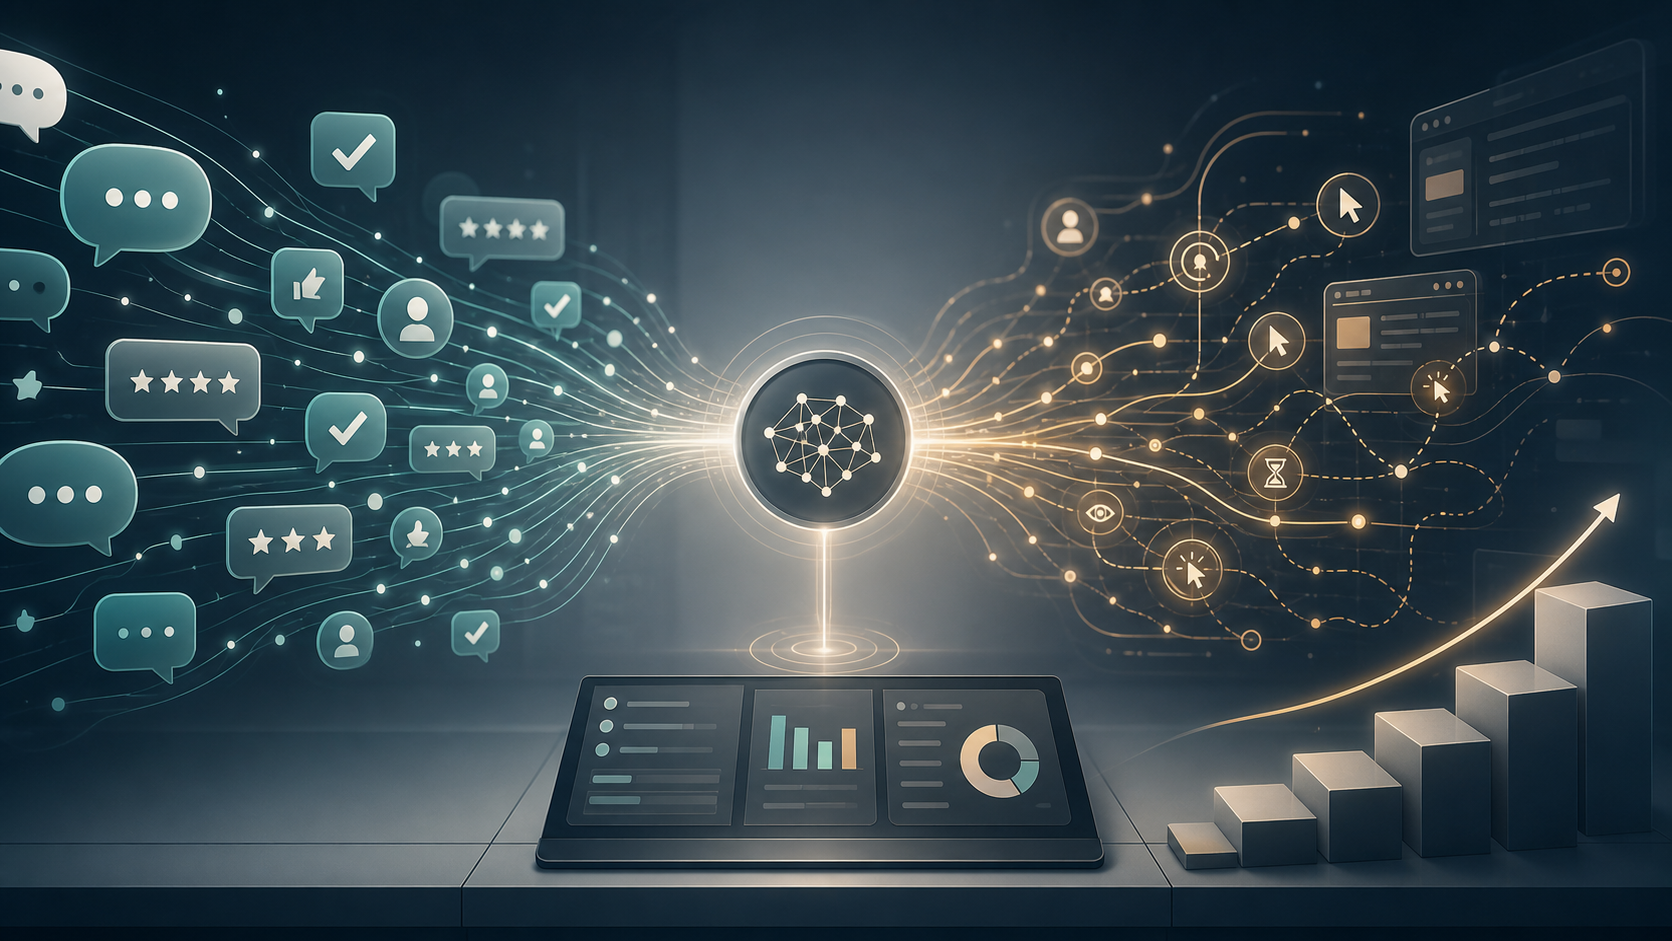
| 比較軸 | 明示シグナル | 暗黙シグナル | ハイブリッド |
|---|---|---|---|
| 取り方 | ボタン、星評価、コメント | コピー、再質問、放棄、滞在時間 | 両方を統合ログで保存 |
| 強み | 意図が明確、低評価理由を取りやすい | 押さなくても集まる、量が確保できる | 量と意図の両方を確保できる |
| 弱み | 押下率が低い、サンプリングが偏る | ノイズが多い、解釈が難しい | 設計と保存先の整理が増える |
| 向くケース | 重要回答や高リスク業務 | チャット型、社内ツール、軽量タスク | 本番運用全般 |
サムズダウンには、自由記述コメント欄を必ず付けます。理由が取れないと、検索・生成・UIのどこに起因するか分類できません。
暗黙シグナルは、操作ログから抽出します。「ユーザーが回答を受け入れたか」を行動で推定する考え方です。
明示・暗黙のシグナルは、同じ会話IDで統合ログに正規化します。後段の評価データ化で照合できるかが、ループの成否を分けます。
集めたシグナルを、評価データセットへ昇格させる手順を決めます。ここを省くと、改善はいつまでも「気になる例の場当たり修正」に留まります。
| 比較軸 | 確認すること | 実務上の意味 |
|---|---|---|
| 抽出基準 | 低評価、暗黙シグナル、業務影響度 | 改善優先度を客観的に決められる |
| レビュー担当 | 業務担当、品質担当、AI担当の役割 | 正解の判断を一人に押し付けない |
| 正解付与 | 期待出力、許容範囲、回答拒否の扱い | 評価結果が再現できるようになる |
| 難易度区分 | 簡単、中、難、回答拒否すべき | 改善のレバーがどこに効くか分かる |
| PII配慮 | マスキング、保存期間、権限分離 | 評価データ自体が漏えい源にならない |
すべての低評価を平等に扱うと、影響の小さい例で時間を消費します。業務影響度の重み付けで並べ替えます。
正解付与は、業務担当・品質担当・AI担当の3者で進めます。AI担当だけで決めると、業務での妥当性がぶれます。
評価データは機密情報の塊になりやすいため、収集前にルールを決めます。
改善は、コストの低い層から順に動かします。モデルやファインチューニングは最後にします。
| 層 | 改善対象 | 反映スピード | 主な指標 |
|---|---|---|---|
| プロンプト・ロジック | システムプロンプト、回答拒否、分岐 | 即時〜1日 | プロンプト変更回数、A/B勝率 |
| RAG・検索 | チャンク分割、検索方式、リランク | 数日〜2週間 | ヒット率、根拠忠実度 |
| ツール・関数 | 関数定義、引数、エラーハンドリング | 数日〜2週間 | ツール呼び出し成功率 |
| モデル・FT | モデル切替、ファインチューニング | 数週間〜数か月 | 正答率、コスト、遅延 |
何をどこに反映したかを記録できないと、回帰評価で原因を切り分けられません。
プロンプト改善で品質が頭打ちになったら、RAGや関数定義に進みます。順番を飛ばすと、根本原因と改善の効果を切り分けにくくなります。
改善反映後は、回帰評価と本番監視の両輪で確認します。片方だけだと、見落としやすい劣化が残ります。
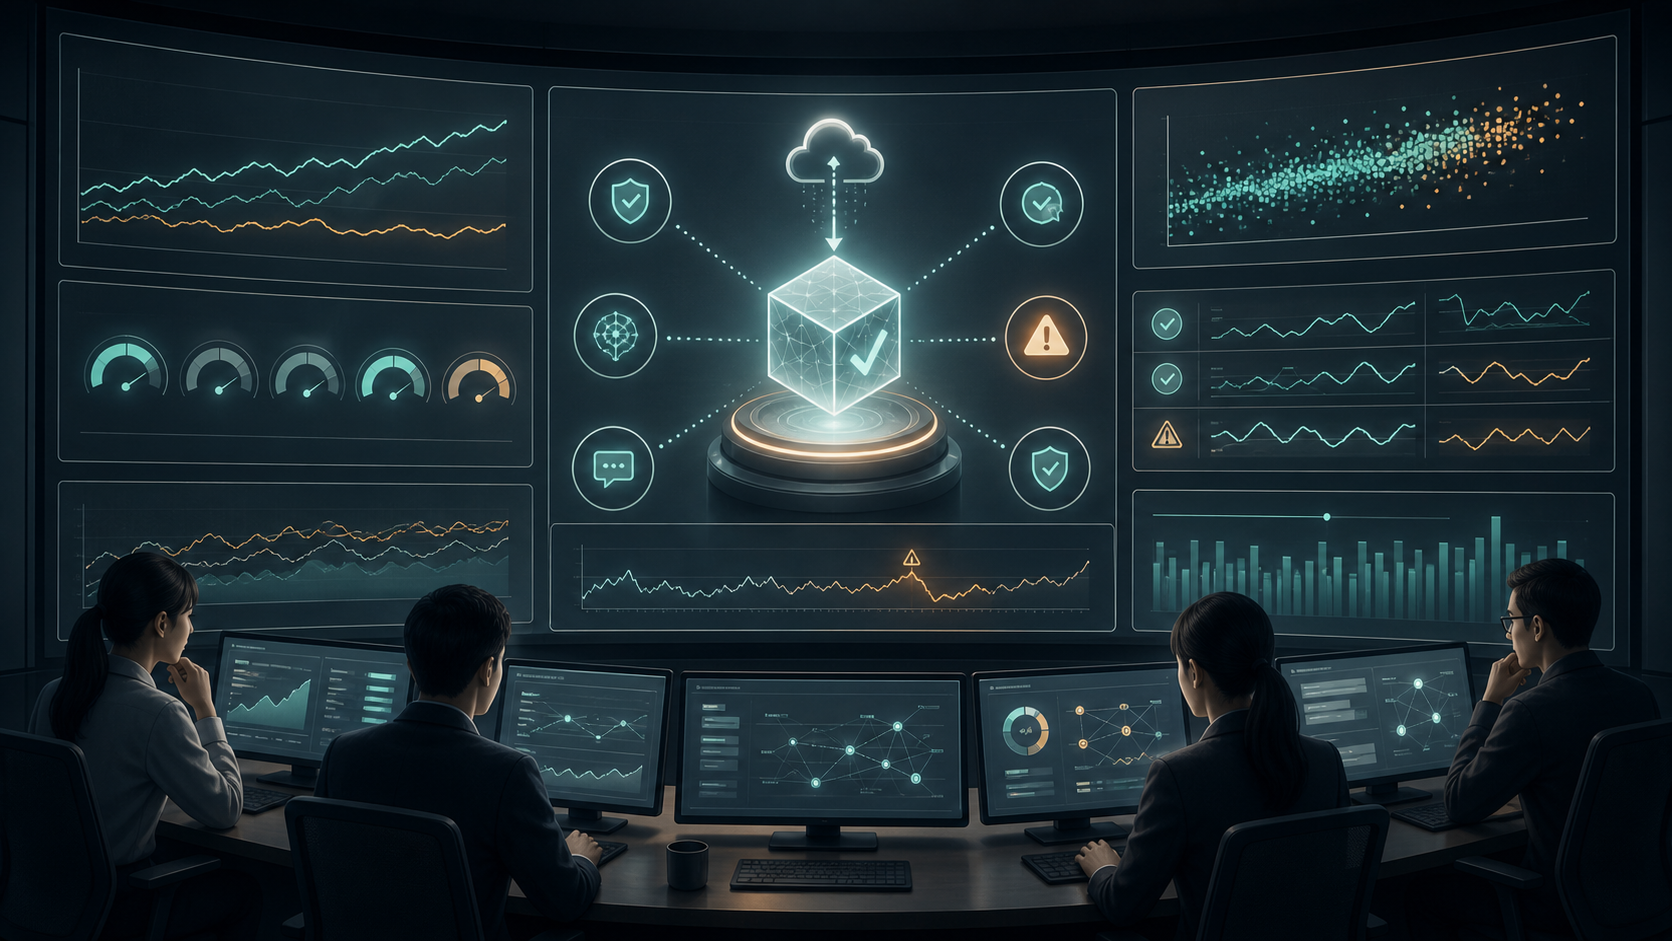
監視と改善の境界が曖昧になりやすいため、運用責任者と週次レビューの頻度を必ず決めます。
導入前に揃えるチェックリストです。1人の担当者に集中させない設計を目指します。
運用開始後に最初に見る指標は次の3つです。
採用しないほうがよい条件もあります。
フィードバックループは万能ではありません。前提の偏りが、改善判断を狂わせます。
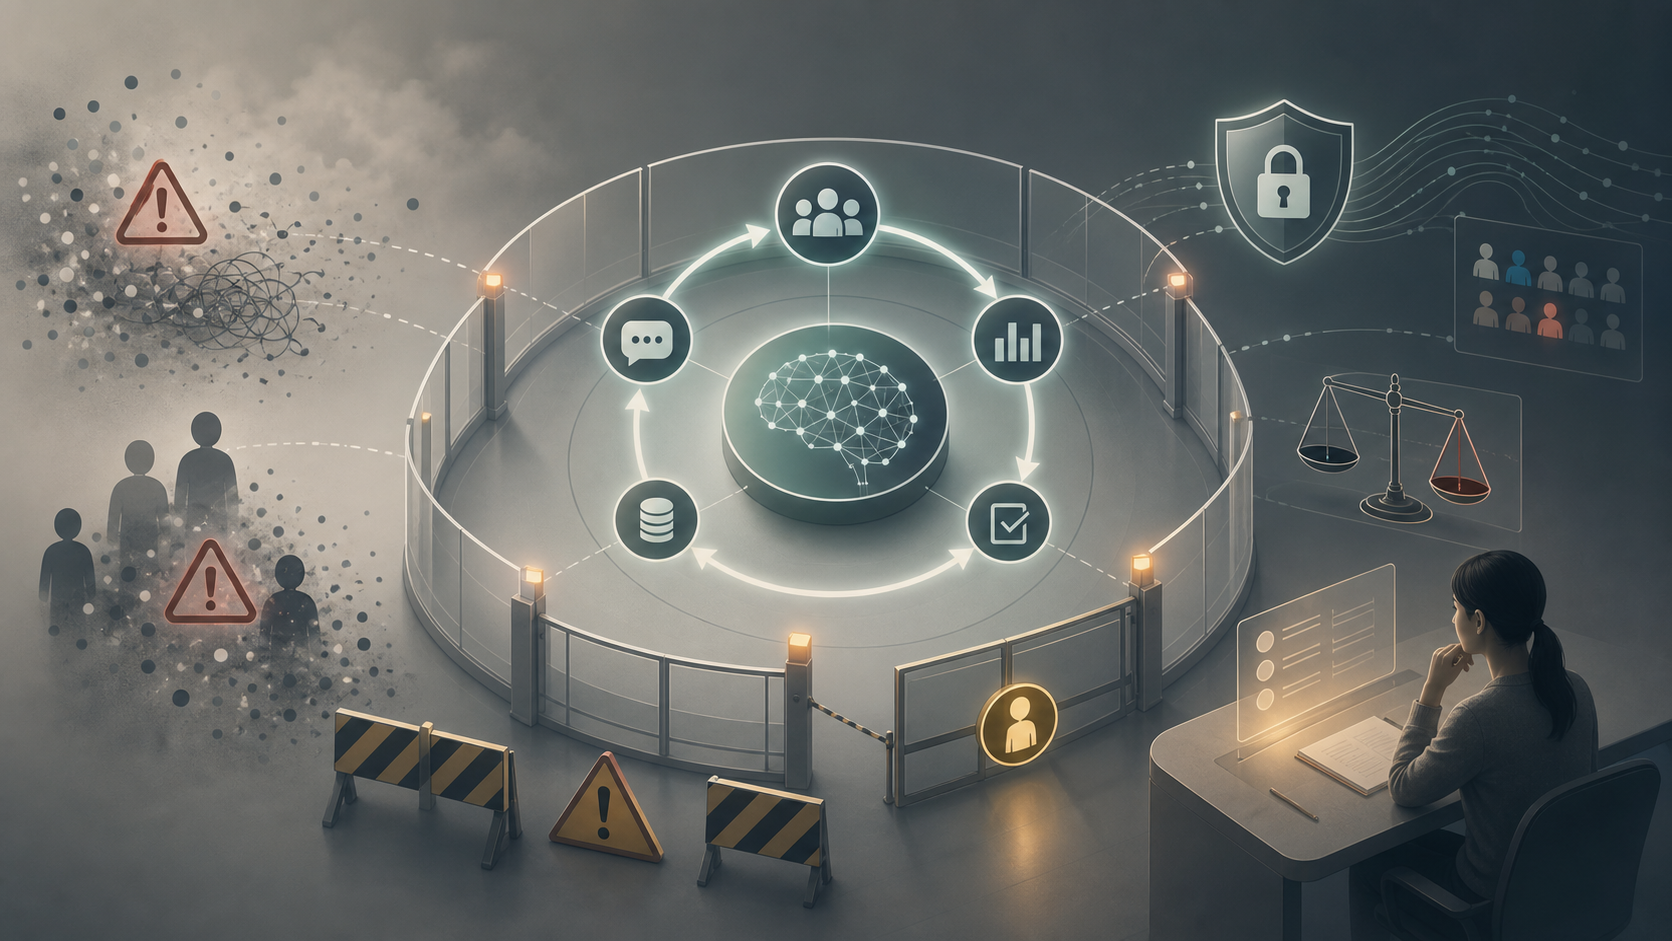
リスクを抑えるには、暗黙シグナルの併用、人手レビュー、データ保管ルールの明文化を必ず組み合わせます。
Blackford Technologiesは、LLMアプリの導入後にフィードバックループを業務に組み込んで運用責任者を置くことが、定着の最大の分岐点だと考えます。技術的には正しくても、ループが回らなければ品質は静かに劣化します。
支援できる範囲は次の通りです。
社内データを横断するナレッジ検索や評価データの整備には、社内設置型のAIデータ基盤DataRoidが選択肢になります。
既存クラウド資産を活かして段階導入したい場合は、VPC内に展開できるDataRoid Cloud、営業・商談文脈と接続したい場合はSalesRoidが候補になります。
本番運用後の改善ループ伴走は、FDE・アフターサービスで支援します。
\LLM運用のフィードバックループ設計を相談できます/
Blackfordに相談する
Q. サムズアップ/ダウンだけで改善は回りませんか?
A. 押下率が低く、サンプリングも偏るため改善判断には不足します。コピーや再質問など暗黙シグナルを併用し、両者を統合ログで保存する設計が現実的です。
Q. ゴールデンデータセットはどのくらいの件数から始めればよいですか?
A. 初期は50〜100件で十分始められます。重要な業務カテゴリを網羅し、回答拒否すべき例や難しい例を含めると、初期の改善判断が安定します。
Q. 本番ログを学習に使う際の注意点は何ですか?
A. 個人情報や機密情報のマスキング、保存期間、参照権限、業務側合意を先に決めます。LLMのデータ取り扱い条件は変更があるため、公式情報で都度確認してください。
Q. プロンプト管理はスプレッドシートでも始められますか?
A. 初期は可能です。版番号、変更日時、変更理由、評価結果を最低限残すことが条件です。本番A/Bや回帰評価を増やす段階で、専用ツールへの移行を検討します。
Q. 改善ループの責任者はどの部署が担うべきですか?
A. 業務オーナーと品質担当を兼ねるチームが現実的です。AI担当だけに任せると業務妥当性がぶれ、業務側だけに任せると改善が止まります。両者を含む週次レビュー体制が回りやすい構成です。
LLMアプリのフィードバックループは、ユーザーシグナルを評価データへ変え、改善に反映し、再びシグナルで検証する4段階で設計します。サムズアップ単独では改善判断に届かず、暗黙シグナルと組み合わせ、評価データ化のレビュー担当とPII方針を先に決めることが、ループを止めない条件です。
自社のLLM運用で「最初に整える収集経路」と「責任者の置き方」に迷う場合は、業務課題、データ、評価指標、運用責任の観点で整理したうえで、専門家に相談しましょう。




